Início
» Como fazer
»
Inicializando o Ubuntu Server em Modo de Emergência: Um Guia de Resgate Passo a Passo
Inicializando o Ubuntu Server em Modo de Emergência: Um Guia de Resgate Passo a Passo
Cenário ilustrativo: Casey mantém uma máquina virtual hipotética do Ubuntu Server que entra em modo de emergência após uma reinicialização, logo depois da adição de uma montagem opcional de volume de dados /etc/fstab. Casey tem acesso ao console, mas não a uma sessão SSH. A alteração na montagem é uma pista, não uma causa comprovada: o modo de emergência pode ocorrer após várias falhas de inicialização, então Casey verifica os logs da máquina atual antes de alterar qualquer coisa. Os painéis de terminal abaixo mostram layouts representativos e saídas de exemplo, não representando um reparo ou teste real.
O que significa modo de emergência?
Em uma instalação do Ubuntu Server usando systemd, o comando `systemctl` emergency.targetinicia um shell mínimo no console principal. Ele é mais limitado que rescue.targeto `systemctl`, que inicia o sistema básico e monta o sistema com apenas os serviços essenciais. Dependendo do caminho percorrido ao entrar no modo de emergência, o sistema de arquivos raiz pode já estar montado em modo somente leitura ou leitura/gravação. Verifique isso antes de assumir qualquer um dos estados. Consulte a documentação do systemd sobre o alvo especial `systemd` .
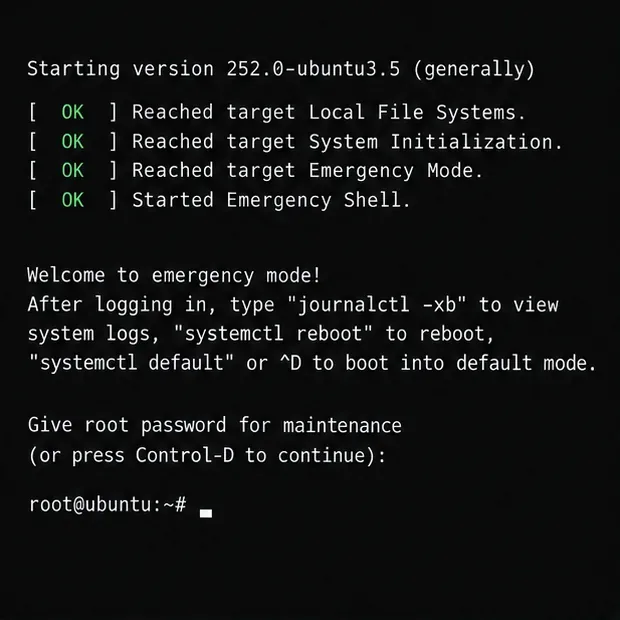
Primeiro, identifique a mensagem. Um shell de emergência do systemd normalmente exibe "Bem-vindo ao modo de emergência!" e pode solicitar a senha de root para manutenção. Uma mensagem do BusyBox, como " (initramfs)A inicialização ainda não foi feita para o sistema de arquivos raiz instalado"; uma mensagem "A inicialização não foi feita para o sistema de arquivos raiz instalado" grub>ou "A inicialização não foi feita para o grub rescue>sistema de arquivos raiz instalado" indica um problema no carregador de inicialização. Esses casos exigem caminhos de recuperação diferentes. Se a conta root estiver bloqueada ou o servidor for remoto, use o console serial/VNC ou o ambiente de recuperação do provedor de hospedagem; o SSH geralmente não está disponível nesta etapa. Não pressione Ctrl+D para continuar até que você entenda e corrija a falha relatada.
Resgate passo a passo
1. Mantenha o acesso ao console e registre a falha exata.
Permaneça no console de emergência. Anote o último nome de montagem ou serviço com falha e qualquer caminho de dispositivo ou UUID impresso acima do prompt. fstabVale a pena verificar a edição recente de Casey, mas não comente todas as linhas com falha nem execute um comando de reparo baseado apenas na palavra "emergência". Se o sistema for uma máquina virtual, mantenha o console do provedor aberto durante o reparo e a próxima reinicialização.
O console identifica o modo de emergência do systemd e fornece um shell de manutenção; a autenticação e a redação podem variar de acordo com a configuração.
2. Leia o diário de inicialização atual e as unidades com falha.
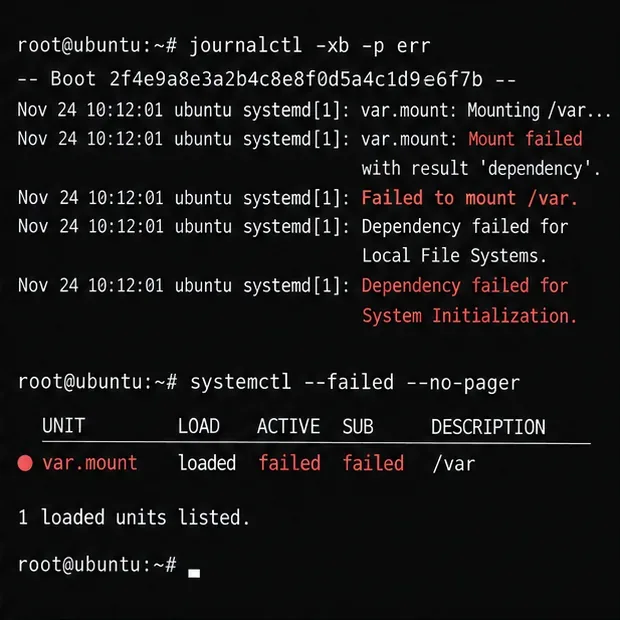
-bA consulta ao diário é limitada a esta inicialização e -p errfiltra por prioridade de erro e superiores. Procure o primeiro erro relevante, não apenas a última sequência de mensagens de "falha de dependência". Se uma unidade de montagem falhou, anote o nome da unidade com caracteres de escape e o caminho de destino; se um serviço falhou, identifique se ele é a causa ou apenas a consequência de uma montagem ausente. journalctl(1)O manual do Ubuntu documenta a inicialização e a filtragem de unidades.
A saída representativa do log de inicialização aponta para uma dependência de montagem com falha; o nome da unidade e a mensagem reais devem vir do servidor.
3. Verifique o ponto de montagem do diretório raiz e o espaço disponível.
Antes de editar arquivos ou tentar reparos, verifique como o sistema de arquivos raiz está montado e se o sistema ficou sem blocos ou inodes:
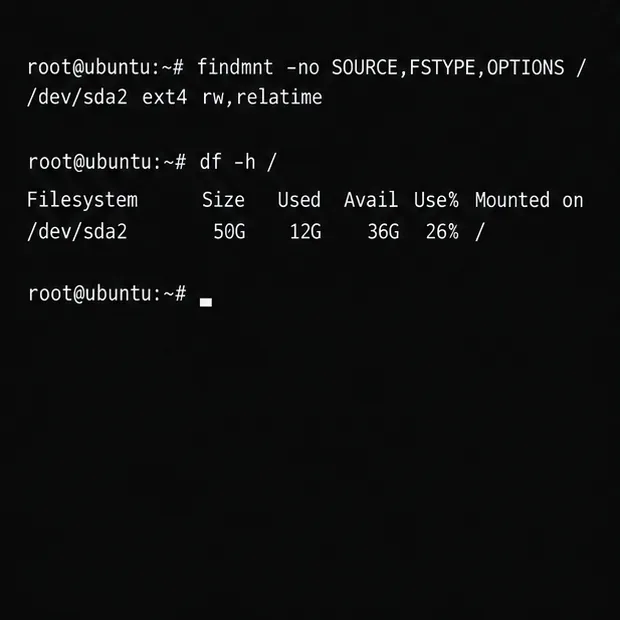
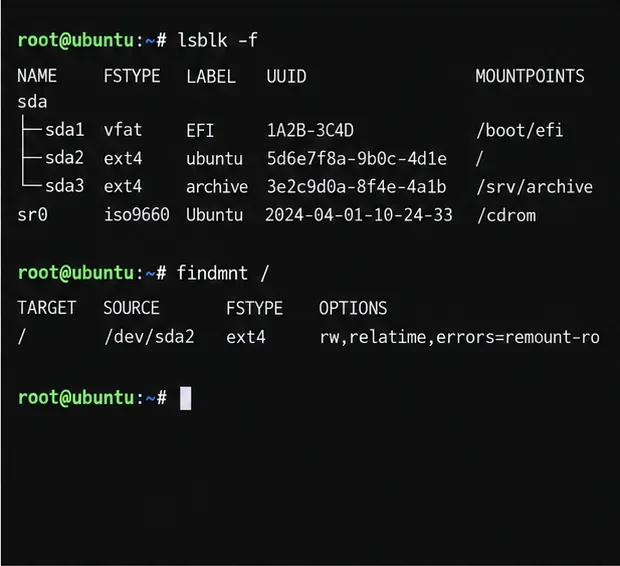
Na findmntsaída, ro`read-only` significa somente leitura e rw`read-write` significa leitura e gravação. Um sistema de arquivos raiz somente leitura pode ser intencional durante parte de um processo de recuperação ou pode refletir problemas no sistema de arquivos. Não force imediatamente uma remontagem como leitura e gravação se os logs do kernel relatarem erros de E/S ou do sistema de arquivos. Um sistema de arquivos cheio ou uma tabela de inodes esgotada também podem causar falhas em serviços e montagens não relacionados. O findmnt(8)manual do Ubuntu descreve como inspecionar sistemas de arquivos montados.
Os comandos revelam se o diretório raiz está montado em modo somente leitura ou leitura e gravação, e se há blocos de disco disponíveis.
4. Validar /etc/fstabe verificar os identificadores do dispositivo
Como Casey mudou recentemente /etc/fstab, verifique sua sintaxe e se os dispositivos referenciados existem:
findmnt --verify --verbose
lsblk -f
blkid
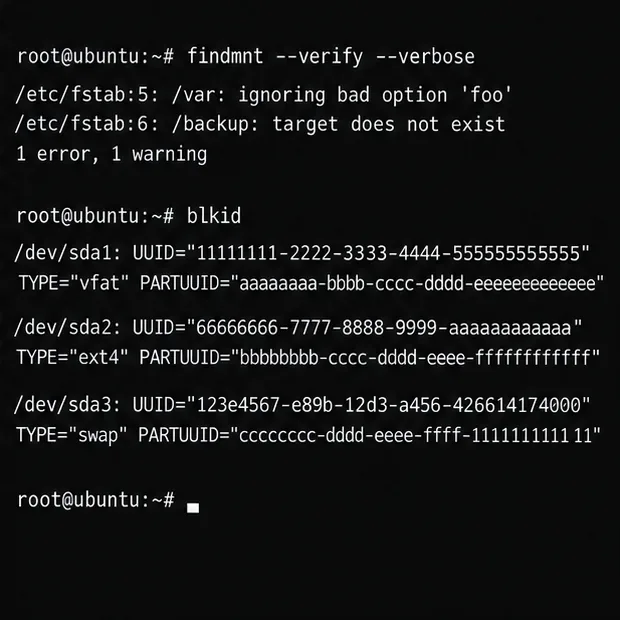
findmnt --verify --verboseVerifica as entradas do fstab em busca de problemas de análise e usabilidade. Compare cada entrada UUID=na linha suspeita com o UUID exibido por ` fstab` lsblk -fou ` blkidfstab`. Verifique também o ponto de montagem, o tipo de sistema de arquivos e as opções. Um UUID copiado de outro disco, um dispositivo não conectado ou uma opção inválida podem impedir a conclusão de uma montagem necessária. Não tente adivinhar o nome de uma partição, como /dev/sda1`/dev/sda`; os nomes dos dispositivos podem mudar entre inicializações.
O validador reporta problemas no fstab enquanto o blkid lista os UUIDs dos dispositivos para comparação com a entrada suspeita.
5. Corrija apenas o problema de montagem confirmado.
Se o sistema de arquivos raiz for gravável e a verificação do fstab identificar uma linha corrompida, faça um backup antes de editar:
cp -a /etc/fstab /etc/fstab.before-rescue
nano /etc/fstab
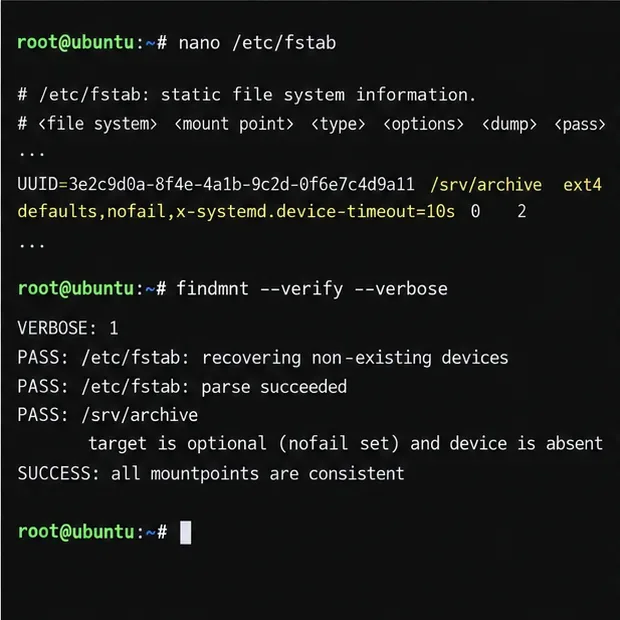
Corrija o UUID ou outro campo somente após confirmar o dispositivo pretendido. Se a montagem for realmente opcional e o servidor ainda precisar inicializar quando esse volume estiver ausente, uma linha do fstab compatível com systemd pode ser usada, nofailjuntamente com uma espera finita do dispositivo, por exemplo:
Substitua o marcador pelo UUID real e use o tipo de sistema de arquivos correto. Não adicione nofailao sistema de arquivos raiz, de inicialização ou outros sistemas de arquivos necessários para o funcionamento correto da máquina ou de seus aplicativos. Com essa opção, a inicialização prossegue mesmo se a montagem falhar, portanto, os serviços dependentes ainda podem precisar de atenção. O manual do módulo mount-unit do systemdnofail do Ubuntu documenta essas opções do fstab.
Após editar, valide novamente antes de tentar montar:
findmnt --verify --verbose
systemctl daemon-reload
mount /srv/archive
Use o ponto de montagem real do último comando. Se ainda assim falhar, leia o novo erro e verifique se o disco está conectado e íntegro. Se o sistema de arquivos raiz for somente leitura, não force alterações sem antes verificar; use um ambiente de recuperação do provedor ou uma mídia inicializável do Ubuntu para inspecionar e editar o sistema instalado com segurança.
O exemplo marca apenas a montagem de um arquivo não essencial como opcional e verifica o fstab posteriormente.
6. Investigue um serviço com falha somente quando o registro apontar para uma falha.
O modo de emergência não significa que toda falha de serviço causou a interrupção da inicialização. Se o erro em questão mencionar um serviço, inspecione essa unidade e seus registros em vez de mascará-la ou desativá-la.
systemctl status example.service --no-pager
journalctl -u example.service -b --no-pager
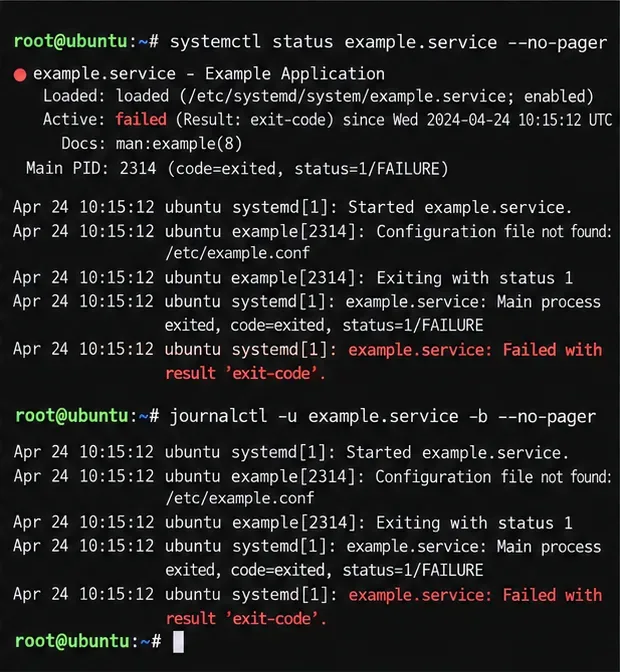
Substitua example.servicepelo nome exato da unidade. Verifique se o arquivo de configuração, o executável, as credenciais ou o ponto de montagem necessário estão faltando. Se a falha for consequência do volume de dados ausente de Casey, corrija esse ponto de montagem primeiro e depois reavalie o serviço. Desativar um serviço essencial pode mascarar o sintoma, deixando o servidor inutilizável.
O status do serviço e o registro de logs ajudam a separar a causa raiz das falhas causadas por outra dependência ausente.
7. Trate os erros do sistema de arquivos como uma tarefa de reparo offline.
Se o diário do kernel reportar corrupção do sistema de arquivos ou erros de E/S de armazenamento, interrompa as gravações sempre que possível e preserve um backup ou snapshot do provedor antes de reparar. Confirme o dispositivo e o sistema de arquivos exatos com o comando `ls -l` lsblk -f. Para um sistema de arquivos raiz, inicialize o sistema a partir do sistema de recuperação do provedor ou da mídia de recuperação/live do Ubuntu, certifique-se de que a partição de destino esteja desmontada e use a ferramenta de verificação apropriada para esse sistema de arquivos. Para ext2/3/4, essa ferramenta é e2fscko `ls -l`; XFS, Btrfs e outros formatos têm procedimentos diferentes.
Nunca execute fsckcomandos e2fsckem um sistema de arquivos montado, incluindo um sistema de arquivos raiz somente leitura montado. O e2fsck(8)manual do Ubuntu alerta que verificar um sistema de arquivos montado geralmente é inseguro e que os resultados não são válidos. Se o disco apresentar erros de E/S repetidos, priorize a recuperação de dados ou o contato com o provedor de armazenamento em vez de tentar reparos repetidamente.
A listagem do disco ajuda a identificar a partição correta; o sistema de arquivos raiz permanece montado, portanto não está pronto para o fsck.
8. Retorne à inicialização normal e verifique o resultado.
Após a correção da causa confirmada, reinicie a partir do console:
systemctl reboot
Após o Ubuntu iniciar, verifique o alvo padrão configurado, o estado atual do sistema, as unidades com falha e a nova inicialização:
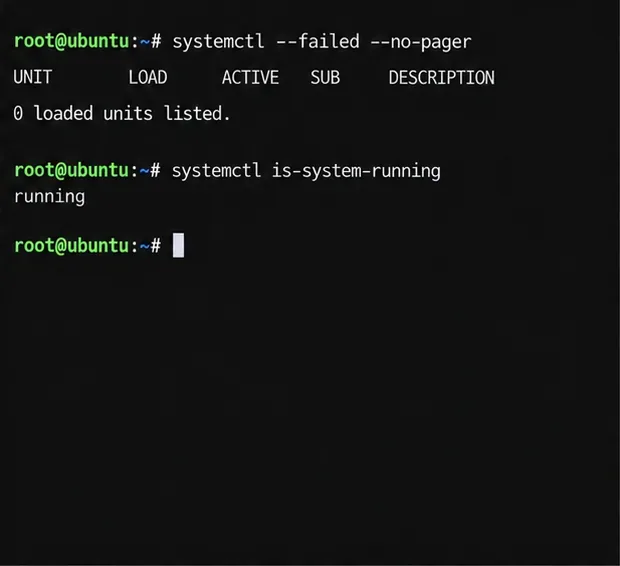
Se você estiver intencionalmente continuando na inicialização atual, systemctl defaulto sistema solicitará ao systemd que inicie o destino padrão configurado. Use-o somente após a correção do erro de bloqueio; ele não repara uma montagem inválida ou um sistema de arquivos danificado. systemctl get-defaultO comando `systemctl` mostra o destino padrão configurado e systemctl is-system-runninginforma se o systemd considera o estado atual como em execução, degradado ou outro. Uma recuperação limpa significa que os sistemas de arquivos esperados estão montados, os serviços necessários estão ativos e a mesma condição de emergência não ocorre novamente após a reinicialização.
O terminal exibe as verificações do systemctl em busca de unidades com falha e se o sistema está funcionando após a reinicialização.
Se o prompt for (initramfs)em vez disso
Não aplique cegamente os passos do shell de emergência do systemd no initramfs do BusyBox. O estágio initramfs tenta localizar e montar o sistema de arquivos raiz real antes de passar o controle para o sistema instalado. Registre o erro exato, verifique se o dispositivo esperado aparece em `/etc/systemd/system/disk/disk` /deve `/etc /dev/disk/by-uuid/systemd/system/disk/disk`, e compare o valor da linha de comando de inicialização root=com o UUID raiz real. Se o disco ou o volume criptografado/LVM estiver ausente, use as ferramentas de armazenamento e recuperação do provedor para investigar. Reconstruir o initramfs ou alterar os parâmetros do GRUB sem identificar o dispositivo ausente pode dificultar a recuperação da inicialização.
Para a VM hipotética de Casey, o resultado útil é uma causa verificada e uma correção de escopo restrito: restaurar o volume opcional esperado, corrigir seu identificador confirmado ou configurá-lo como opcional somente se a carga de trabalho realmente permitir. Em seguida, verifique a próxima inicialização a partir do console antes de encerrar a sessão de recuperação.