Início
» Hoje
»
Memória RAM e inteligência artificial: por que o debate de Sam Altman importa em novembro de 2026
Memória RAM e inteligência artificial: por que o debate de Sam Altman importa em novembro de 2026
Atualizado em 4 de novembro de 2026, às 14h36 (horário de Brasília, BRT, UTC−03:00; 17h36 UTC).
A memória RAM ganhou destaque no debate sobre inteligência artificial depois de uma entrevista publicada em 29 de outubro de 2026 em que Sam Altman, CEO da OpenAI, discutiu a utilização de chips de memória em computadores pessoais e data centers. A questão vai além de uma polêmica: sistemas de IA precisam armazenar modelos e dados temporários em memórias rápidas, e a demanda por capacidade e largura de banda influencia desde o preço de componentes até a viabilidade de executar modelos no próprio PC.
A discussão envolve uma escolha real entre IA na nuvem e IA local, mas não significa que a RAM do computador tenha se tornado dispensável. Quanto mais complexa a tarefa, mais importante é entender a diferença entre RAM, memória da placa de vídeo (VRAM), memória de alta largura de banda (HBM) e armazenamento SSD.
Destaques
Sam Altman discutiu a eficiência de alocar DRAM entre PCs e servidores em entrevista publicada em 29 de outubro; a afirmação sobre uso de memória foi um argumento dele, não uma medição universal.
A RAM sustenta programas, dados e parte da execução de IA; já a VRAM ou HBM costuma ser crucial quando o modelo é processado por aceleradores.
Em modelos de linguagem, pesos do modelo e cache de contexto consomem memória, especialmente em conversas longas e múltiplos acessos simultâneos.
Não existe uma quantidade única de RAM que sirva para toda IA: o requisito depende do modelo, do hardware e de a execução ocorrer localmente ou na nuvem.
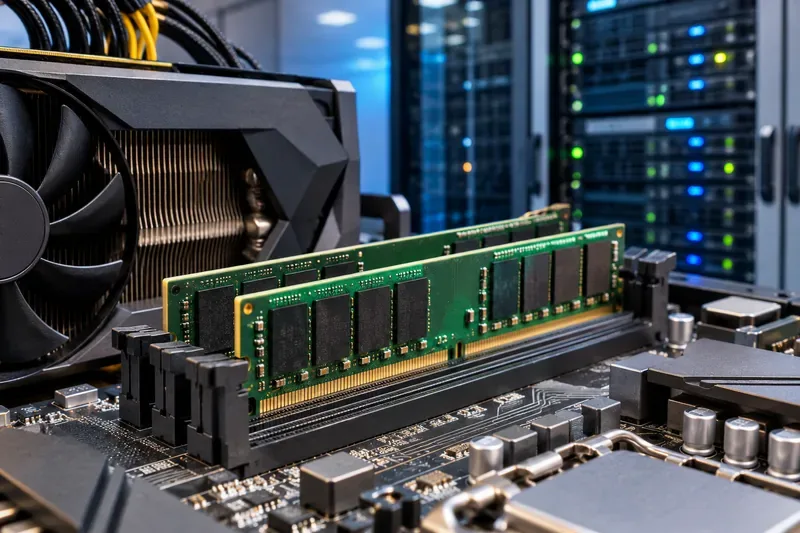
Imagem ilustrativa: módulos de RAM em um computador, com infraestrutura de servidores ao fundo. A capacidade de memória influencia a execução de aplicações de inteligência artificial.
O que Sam Altman disse sobre memória RAM?
No episódio do podcast Cheeky Pint divulgado em 29 de outubro de 2026, Altman argumentou que, em um cenário de oferta limitada de DRAM, concentrar memória em data centers poderia permitir maior utilização do recurso do que distribuí-la por máquinas individuais que ficam ociosas parte do dia. Ele mencionou 5% de utilização como parte de seu raciocínio. Isso não deve ser interpretado como um índice comprovado de uso da memória RAM em todos os computadores.
A transcrição original da entrevista Cheeky Pint permite conferir a fala no contexto de uma conversa sobre restrições da cadeia de suprimentos e capacidade computacional. O argumento econômico não estabelece que rodar IA no computador seja tecnicamente errado, nem elimina motivos legítimos para isso, como privacidade, trabalho offline e controle sobre os dados.
A conexão entre IA e a indústria de memória também é concreta. Em outubro de 2025, anúncio oficial da parceria entre OpenAI, Samsung e SK informou que as empresas pretendiam ampliar a produção de chips avançados, com uma meta de expansão industrial anunciada — não uma capacidade já entregue. Em setembro de 2026, a comunicado da Micron de setembro de 2026 apresentou um módulo DDR5 de 512 GB demonstrado para servidores, direcionado a aplicações exigentes de IA e análise de dados. Esses anúncios indicam a importância da memória para o setor, mas não permitem concluir, isoladamente, qual será o preço da RAM no varejo brasileiro.
Qual é a relação entre memória RAM e inteligência artificial?
A RAM é uma memória de acesso rápido usada para manter temporariamente informações que o sistema operacional e os aplicativos estão processando. Em tarefas de IA, ela pode conter dados de entrada, bibliotecas, partes de modelos e resultados intermediários. Sem espaço suficiente, o sistema pode recorrer ao armazenamento em disco ou encerrar operações, o que geralmente prejudica o desempenho.
Entretanto, dizer que um computador tem 32 GB de RAM não significa que sua placa de vídeo tenha 32 GB disponíveis. As tecnologias cumprem papéis relacionados, mas não idênticos:
Componente
Função nas tarefas de IA
O que observar
RAM (DRAM, DDR4/DDR5)
Atende ao processador, ao sistema e aos dados dos aplicativos; pode apoiar modelos executados na CPU.
Capacidade, velocidade e possibilidade de expansão.
VRAM (memória da GPU)
Mantém pesos, ativações e cache de modelos acelerados na placa de vídeo.
Capacidade disponível e largura de banda.
HBM
Memória de altíssima largura de banda usada em diversos aceleradores de IA.
Integração com o acelerador, capacidade e velocidade de transferência.
SSD
Armazena arquivos de modelos e conjuntos de dados de forma persistente.
Espaço e velocidade de carregamento; não substitui RAM ou VRAM.
Em computadores com memória unificada, parte dessas divisões muda: CPU e GPU acessam um conjunto compartilhado de memória física, sob regras e limites próprios da plataforma. É por isso que comparar apenas o número de gigabytes entre um notebook com GPU integrada e um desktop com GPU dedicada pode induzir a conclusões erradas.
Por que modelos de inteligência artificial exigem tanta memória?
Parâmetros, contexto e usuários simultâneos
Um modelo precisa carregar seus parâmetros, também chamados de pesos. Durante a geração de texto, muitos sistemas mantêm ainda um cache de chaves e valores (KV cache) para reutilizar informações da atenção. Esse cache pode crescer com a janela de contexto e com o número de solicitações em paralelo. A documentação técnica da NVIDIA sobre inferência de LLMs apresenta pesos e cache KV como dois fatores centrais no consumo de memória durante a inferência.
Como referência técnica, um modelo com 7 bilhões de parâmetros em precisão de 16 bits exige cerca de 14 GB apenas para os pesos, antes de considerar cache, buffers e outras despesas. Isso não significa que 14 GB de RAM total bastem para executá-lo: a memória necessária depende da arquitetura, do software e do dispositivo que fará o processamento.
Por que quantização e otimização ajudam?
A quantização armazena pesos com menos bits. Ela pode reduzir expressivamente a memória exigida e facilitar a execução local, embora o efeito na qualidade e na velocidade dependa do método e do hardware. Outras técnicas distribuem partes do modelo entre memória do sistema e aceleradores, reduzem o cache ou processam solicitações em lotes. Essas soluções ampliam as possibilidades, mas podem trocar economia de memória por maior latência.
Quanto de RAM é necessário para usar IA no PC?
Primeiro, é preciso distinguir usar um serviço online de executar o modelo localmente. Quem acessa um chatbot pelo navegador normalmente não precisa manter seus pesos no próprio computador: grande parte do cálculo ocorre em servidores remotos. Já quem executa um modelo baixado, trabalha com imagens localmente ou treina redes neurais precisa considerar RAM, GPU, VRAM, espaço em disco e requisitos do software.
8 GB: podem atender a tarefas comuns e acesso a serviços de IA na nuvem, dependendo do navegador e dos aplicativos abertos. Não são referência geral para modelos locais.
16 GB: oferecem mais margem para multitarefa e algumas ferramentas locais leves. A Microsoft define 16 GB ou mais como um dos requisitos da categoria Copilot+ PC, juntamente com hardware específico, mas isso não é o mínimo universal para toda aplicação de IA.
32 GB ou mais: podem ser úteis para desenvolvimento, múltiplos aplicativos, bases de dados e modelos locais mais exigentes. Ainda assim, a VRAM pode ser o principal gargalo.
O guia oficial de IA no Windows da Microsoft diferencia ferramentas que exigem recursos específicos dos Copilot+ PCs de plataformas que também funcionam em outros computadores Windows. Antes de comprar memória, consulte os requisitos do modelo e monitore o consumo real de RAM e VRAM durante a tarefa pretendida.
IA na nuvem ou no computador: qual opção faz mais sentido?
A nuvem concentra processadores, aceleradores e memória compartilhados por muitos usuários. Pode facilitar o acesso a modelos maiores, atualizações frequentes e maior capacidade de processamento sem exigir uma estação de trabalho cara. Em contrapartida, o serviço depende de conexão, políticas de tratamento de dados, limites de uso e custos definidos pelo fornecedor.
A execução local dá mais controle sobre o ambiente e pode permitir funcionamento offline e processamento de dados sem enviá-los a um provedor externo, quando o software realmente opera integralmente no dispositivo. O custo inicial, a energia consumida e os limites de memória ficam com o usuário. O melhor caminho depende do nível de privacidade exigido, do orçamento e do desempenho necessário — não apenas da utilização média do chip.
A demanda por IA pode encarecer a memória RAM?
O aumento da demanda por memória para servidores e aceleradores pode pressionar a cadeia de suprimentos, mas preços ao consumidor dependem também de produção, estoques, contratos, câmbio, impostos e concorrência. Não é possível prever uma alta específica no Brasil apenas a partir de uma entrevista ou de um anúncio de investimento.
O efeito mais provável para quem compra tecnologia é a crescente importância de avaliar capacidade e largura de banda antes de escolher o equipamento. Se fabricantes ampliarem a produção e técnicas de IA reduzirem o consumo por tarefa, parte da pressão poderá diminuir; se a demanda crescer mais rápido do que a oferta, a disputa por componentes poderá persistir. Ambas são possibilidades condicionais, não previsões garantidas.
Perguntas frequentes sobre RAM e IA
Mais RAM deixa qualquer inteligência artificial mais rápida?
Não. RAM adicional ajuda quando falta memória, mas processador, GPU, VRAM, largura de banda e otimização do modelo também influenciam o desempenho.
Qual é a diferença entre RAM e VRAM para executar modelos?
A RAM atende principalmente à CPU e ao sistema. A VRAM fica associada à GPU e costuma armazenar os dados usados nos cálculos acelerados; algumas plataformas utilizam memória unificada.
É preciso ter 32 GB de RAM para usar ChatGPT ou outros chatbots?
Não. Chatbots executados na nuvem não exigem essa quantidade específica no computador do usuário. Para modelos locais, consulte os requisitos de cada aplicação e o total de memória disponível.