Início
» Como fazer
»
Pool fino do SLES sem espaço: estenda o LVM com segurança e restaure as gravações.
Pool fino do SLES sem espaço: estenda o LVM com segurança e restaure as gravações.
Quando um volume com provisionamento dinâmico (thin-provisioned) do SUSE Linux Enterprise Server reporta "sem espaço disponível no dispositivo", verifique primeiro o pool dinâmico Data%. Meta%Se a área de dados estiver cheia e o grupo de volumes tiver extensões livres, expanda o pool dinâmico com lvextendo tamanho necessário — e não apenas com o tamanho virtual do seu volume lógico dinâmico. Uma área de metadados completamente cheia é diferente: pode ser necessário realizar reparos offline antes que as gravações normais sejam retomadas.
O procedimento abaixo utiliza comandos LVM2 documentados para Linux e o modelo de armazenamento descrito no Guia de Administração de Armazenamento do SUSE Linux Enterprise Server 15 SP7 . A disponibilidade de comandos e a configuração de serviços podem variar em outros pacotes de serviços do SLES ou em uma instalação em cluster. Faça um backup consistente com o aplicativo e restrinja gravações intensivas antes de modificar o armazenamento de produção.
1. Verifique se o espaço de dados ou os metadados estão esgotados.
Execute o seguinte comando no host que possui o thin pool ativo, substituindo `< vgdatanome do grupo de volumes>` pelo nome do seu grupo de volumes:
sudo lvs -a -o lv_name,lv_size,segtype,data_percent,metadata_percent,pool_lv vgdata
Procure a linha com ` thin-poolunder` SegType. Data%`measures allocated data blocks; Meta%measures pool's mapping metadata`. Esses são limites de capacidade separados. Se ` Data%is near 100`, mas Meta%estiver confortavelmente abaixo desse valor, extensões de dados adicionais são a solução mais direta. Se ` Meta%is on 100`, use as precauções de recuperação na seção 4.
Exemplo de visualização do terminal: o uso de dados (Data%) do pool está próximo do limite máximo, enquanto o uso de metadados é muito menor. Os valores ilustram os campos a serem inspecionados, não um resultado de diagnóstico em tempo real.
Por exemplo , suponha que vgdata/pool0o pool tenha 100 GiB com 98,12% de uso de dados e 40,26% de uso de metadados. O pool corre risco imediato, mesmo que o df -hsistema reporte bastante espaço disponível dentro de um volume thin montado. O tamanho virtual de um volume thin pode exceder a capacidade física que o suporta, como explica a documentação do Expert Partitioner da SUSE .
Não interprete um resultado vazio do comando grep como prova de que não ocorreram falhas de gravação. Verifique também os logs do aplicativo, especialmente se um banco de dados ou máquina virtual estava gravando quando o pool ficou cheio.
2. Confirme se o grupo de volume possui extensões físicas livres.
Antes de alterar o tamanho do pool, verifique se o grupo de investidores tem recursos para financiar a expansão:
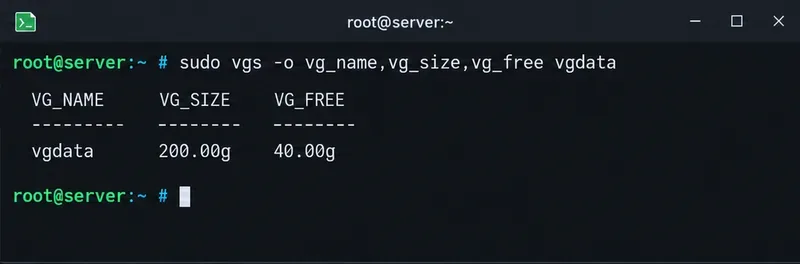
sudo vgs -o vg_name,vg_size,vg_free vgdata
Exemplo de verificação de grupo de volumes: VG_FREE indica se há extensões físicas disponíveis para expandir o pool0 sem adicionar outro dispositivo.
No exemplo hipotético, o grupo de volumes de 200 GiB tem 40 GiB livres. Uma extensão de pool de 20 GiB é, portanto, viável em princípio, sujeita a restrições de alocação e espaço para qualquer crescimento de metadados. Mantenha algum espaço do grupo de volumes em reserva, em vez de atribuir toda a extensão livre ao pool.
Se VG_FREEfor zero, lvextendnão é possível criar capacidade física. Adicione um volume físico corretamente identificado e preparado ao VG, expanda o armazenamento subjacente e seu PV LVM conforme apropriado ou recupere blocos antes de tentar novamente. A SUSE documenta a adição de volumes físicos ao redimensionar um grupo de volumes . Nunca execute pvcreateem um disco não verificado: isso pode destruir os metadados de armazenamento existentes.
3. Amplie a piscina fina em vez do volume fino
Quando Data%o fator limitante for o tamanho do lote, os metadados não estiverem esgotados e houver extensões VG suficientes disponíveis, expanda o próprio pool:
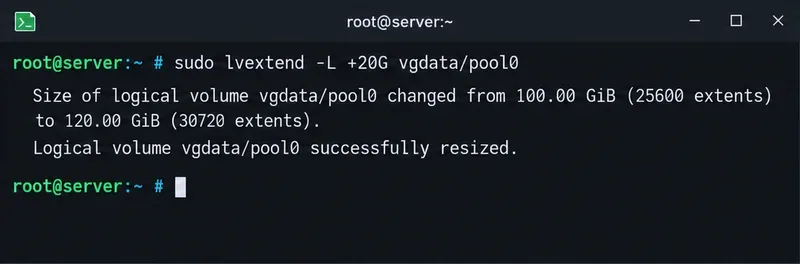
sudo lvextend -L +20G vgdata/pool0
Exemplo de extensão thin-pool: o comando tem como alvo vgdata/pool0, e não o volume lógico thin dentro dele. A resposta exibida é ilustrativa.
A +20Gsintaxe adiciona 20 GiB ao tamanho atual do pool; ela não define o tamanho final para 20 GiB. Neste exemplo, o pool de armazenamento aumenta de 100 GiB para 120 GiB. Com os dados alocados inalterados, 98,12 GiB em uso representariam cerca de 81,8% do pool ampliado. A porcentagem real pode ser diferente se as gravações continuarem durante a operação.
Não substitua .lvextend -L +20G vgdata/thin1 Aumentar o espaço de endereço virtual de um volume fino não adiciona necessariamente capacidade de dados física ao seu pool. Como este comando expande o pool subjacente em vez do dispositivo de bloco virtual do sistema de arquivos, um redimensionamento do sistema de arquivos normalmente não é necessário para esta operação específica. O manual oficial de provisionamento fino do LVM documenta o mecanismo de extensão de pool fino e suas limitações.
Quando não for possível ampliar a piscina imediatamente
Se arquivos já foram excluídos de um sistema de arquivos fino e o descarte é suportado por toda a pilha, considere recuperar os blocos descartados:
sudo fstrim -v /srv/data
Use o ponto de montagem real de um volume fino, não o dispositivo thin-pool. Um TRIM bem-sucedido pode reduzir o tamanho Data%do volume, mas excluir arquivos por si só geralmente não restaura blocos ao pool. Snapshots finos podem reter blocos compartilhados, e um pool configurado para ignorar descartes não se beneficiará disso. Não considere o TRIM como um substituto emergencial confiável para capacidade física, principalmente se as gravações começarem a falhar. Remova snapshots antigos somente após verificar sua propriedade, dependências e requisitos de retenção; a exclusão de snapshots é irreversível.
4. Tratar uma área completa de metadados como uma condição de recuperação.
Se Meta%atingir 100%, interrompa as gravações do aplicativo e planeje uma interrupção controlada. O LVM alerta que o esgotamento de metadados pode tornar os metadados do pool fino e os sistemas de arquivos inconsistentes. Simplesmente aumentar o tamanho dos dados do pool, tentar novamente as gravações ou forçar a ativação não resolve esse risco.
A sequência de recuperação documentada consiste em desativar o pool afetado offline, reparar seus metadados limitados usando [comando/ferramenta] lvconvert --repair VG/ThinPool, aumentar a capacidade dos metadados usando [comando/ferramenta] lvextend --poolmetadatasizee, em seguida, verificar cada sistema de arquivos afetado com a ferramenta offline apropriada. Por exemplo, um pool cujo volume lógico (LV) de metadados seja menor que 2 GiB pode exigir um destino revisado, como:
sudo lvextend --poolmetadatasize 2G vgdata/pool0
Este não é um comando para ser executado cegamente em um pool ativo e danificado. Seu tamanho é um exemplo, não um requisito universal. Confirme primeiro o tamanho atual dos metadados, as extensões disponíveis, a desativação correta, a mídia de recuperação e os backups. lvconvert --repairO planejamento deve levar em consideração o tempo de inatividade e a experiência em recuperação; o manual do LVM observa que ele pode falhar e os dados ainda podem ser irrecuperáveis. Mantenha o LV de metadados antigo até que o pool e os sistemas de arquivos sejam verificados. Um backup de configuração do LVM vgcfgbackupnão faz backup dos metadados do thin pool. Para dados críticos para os negócios, entre em contato com o suporte da SUSE ou sua equipe de recuperação de armazenamento antes de tentar o reparo.
5. Ative a extensão automática e, em seguida, verifique as gravações.
Após o sistema estar estável, configure uma política de crescimento proativo na activationseção de /etc/lvm/lvm.conf. Este exemplo inicia a expansão com 70% de uso e solicita um crescimento de 20%; ajuste esses valores de acordo com a taxa de gravação e a capacidade disponível do VG:
Certifique-se de que as configurações sejam aplicadas ao escopo de configuração correto e que o pool esteja sendo monitorado:
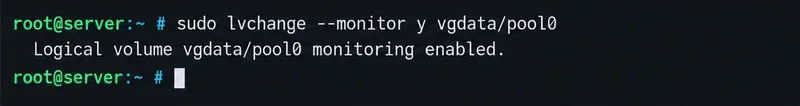
sudo lvchange --monitor y vgdata/pool0
Exemplo de comando de monitoramento: habilitar o monitoramento de eventos LVM permite que as políticas de crescimento automático do pool atuem quando houver extensões livres suficientes.
O crescimento automático do thin pool depende do monitoramento de eventos do LVM ( dmeventd) e de extensões livres suficientes. Verifique o serviço de monitoramento fornecido pela sua instalação do SLES — por exemplo, systemctl status lvm2-monitoronde essa unidade existe — e revise seus logs. Um limite não garante proteção se as gravações excederem a extensão ou se o VG já estiver cheio. Consulte as orientações sobre extensão automática e as opções de monitoramento do lvchange no manual do LVM .
Verifique se a correção funcionou.
Leia novamente a utilização do pool e a capacidade restante do VG:
Data%O espaço ocupado deve ter diminuído após a expansão do pool de dados, Meta%deve permanecer abaixo da capacidade máxima e o pool deve estar ativo, sem novos erros de E/S. Verifique o status do sistema de arquivos e os logs do aplicativo e, em seguida, execute um pequeno teste de leitura e gravação adequado ao aplicativo antes de liberar as cargas de trabalho suspensas. Se os erros persistirem após a disponibilidade de espaço, mantenha a carga de trabalho afetada offline até que a integridade do sistema de arquivos e do aplicativo seja avaliada; mais capacidade não pode reverter gravações já falhas ou perdidas.