Início
» Tecnologia
»
O que causa a indisponibilidade generalizada de plataformas em nuvem? Os padrões de falha por trás de grandes interrupções.
O que causa a indisponibilidade generalizada de plataformas em nuvem? Os padrões de falha por trás de grandes interrupções.
A indisponibilidade generalizada de plataformas em nuvem raramente resulta de um único servidor simplesmente "parar de funcionar". Os incidentes mais disruptivos geralmente começam com uma falha técnica — uma configuração incorreta, um defeito de software, um problema de DNS, uma falha de rede ou um evento de infraestrutura — e se espalham porque muitos serviços dependem dos mesmos planos de controle, bancos de dados, sistemas de identidade, balanceadores de carga ou recursos regionais.
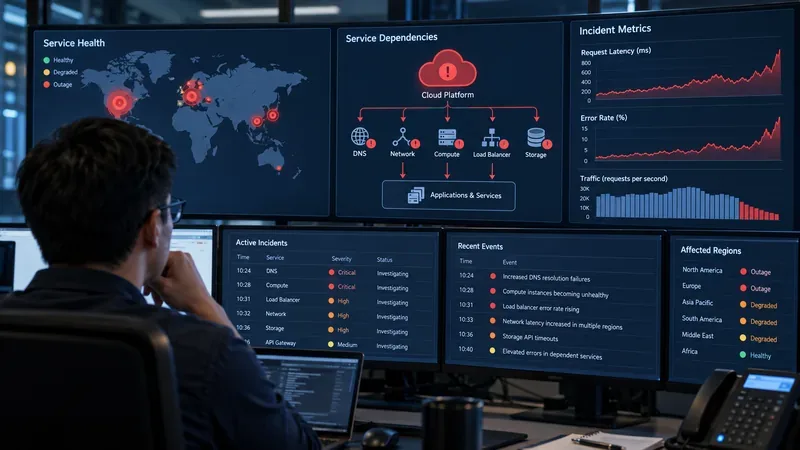
Cenário ilustrativo: imagine um provedor de nuvem fictício chamado Northstar Cloud. Às 10h05, uma alteração automatizada na rede é aplicada a um serviço regional. Em poucos minutos, os clientes começam a relatar falhas em chamadas de API. Às 10h12, novas máquinas virtuais param de ser iniciadas. Às 10h20, os balanceadores de carga começam a marcar servidores íntegros como indisponíveis. Às 10h35, dezenas de produtos aparentemente não relacionados apresentam desempenho degradado. Este cenário é hipotético, não uma descrição de uma interrupção real. Ele é útil porque demonstra como uma pequena falha inicial pode se transformar em um grande evento na plataforma.
As equipes de operações em nuvem frequentemente precisam rastrear uma interrupção desde a primeira dependência com falha, passando por DNS, rede, computação, balanceamento de carga, armazenamento e aplicativos subsequentes.
Resposta curta: grandes interrupções na nuvem geralmente são falhas em cascata.
As principais causas de indisponibilidade generalizada de plataformas em nuvem são erros de configuração e implantação, defeitos latentes de software, falhas de DNS e roteamento, dependências de serviços compartilhados, esgotamento da capacidade durante falhas ou recuperação, problemas no plano de controle e falhas físicas que afetam um data center ou zona de disponibilidade. A escala da interrupção depende menos do erro inicial do que da abrangência do compartilhamento do componente afetado.
Um exemplo prático útil vem da AWS. Em seu resumo oficial pós-evento referente à interrupção de outubro de 2025 no norte da Virgínia, a AWS afirmou que uma condição de corrida latente no sistema automatizado de gerenciamento de DNS do DynamoDB gerou um registro DNS vazio incorreto para o endpoint regional. Essa falha de DNS afetou clientes e serviços internos da AWS que dependiam do DynamoDB, e o trabalho de recuperação posterior contribuiu para problemas envolvendo execuções de instâncias EC2 e balanceadores de carga de rede. O incidente está documentado no resumo pós-evento da AWS referente à interrupção do DynamoDB em outubro de 2025 .
1. Alterações na configuração podem criar um raio de explosão inesperadamente grande.
Erros de configuração estão entre os padrões mais comuns em incidentes em grandes sistemas distribuídos, porque as plataformas modernas são controladas por automação. Uma única alteração pode ser implementada em milhares de hosts, roteadores, registros DNS ou endpoints de serviço mais rapidamente do que um operador humano conseguiria fazer manualmente.
Retomando o cenário da Northstar Cloud, suponhamos que a alteração de rede das 10h05 fosse destinada a dez máquinas, mas foi aplicada a várias regiões. A alteração não precisa destruir o hardware. Ela pode simplesmente remover capacidade de rede utilizável, alterar o roteamento ou fazer com que os sistemas rejeitem tráfego que, de outra forma, seria válido. Quando a capacidade compartilhada cai abaixo da demanda, os clientes veem timeouts e novas tentativas de conexão, o que gera ainda mais carga.
O Google descreveu um mecanismo semelhante em seu relato oficial sobre uma interrupção ocorrida em 2019: uma alteração de configuração destinada a um pequeno número de servidores em uma região foi aplicada incorretamente de forma muito mais ampla, fazendo com que várias regiões parassem de usar mais da metade de sua capacidade de rede disponível. O tráfego, então, congestionou a capacidade restante. Veja a atualização oficial do Google sobre a interrupção de serviço de 2019 .
É por isso que operadores de nuvem experientes utilizam implantações em etapas, validação, reversão automatizada, limites de taxa de alteração e controles de "raio de impacto". Essas medidas de segurança não eliminam incidentes, mas podem impedir que uma alteração problemática se transforme em um evento que afete toda a plataforma.
2. Os defeitos de software podem permanecer ocultos até que ocorram condições temporais raras.
Grandes plataformas em nuvem executam enormes conjuntos de software distribuído. Alguns defeitos permanecem latentes por meses ou anos porque exigem uma sequência rara de eventos: dois controladores atualizando o mesmo estado, um atraso incomum, metadados desatualizados ou um processo de recuperação sendo executado simultaneamente a um processo de limpeza.
No incidente fictício de Northstar, imagine que dois processos de automação independentes atualizam o mesmo plano de DNS. Um deles sofre um atraso, o outro conclui uma atualização mais recente e, em seguida, uma rotina de limpeza remove os dados que o processo atrasado acabou de ativar. Cada componente individual pode parecer estar funcionando conforme o esperado, mas a interação entre eles cria um estado inválido.
O incidente de 2025 no AWS DynamoDB ilustra claramente essa categoria. A AWS atribuiu a falha inicial a uma condição de corrida latente entre componentes redundantes de gerenciamento de DNS. A importância disso vai além de um único fornecedor: a redundância só melhora a confiabilidade quando os componentes redundantes não podem corromper o estado compartilhado por meio da mesma lógica ou falha de sincronização.
3. Falhas no DNS e na rede podem tornar sistemas em bom estado inacessíveis.
Um serviço pode estar totalmente ativo e ainda assim estar efetivamente indisponível se os clientes não conseguirem resolver seu nome de host ou se os pacotes não conseguirem alcançá-lo. DNS, roteamento, balanceamento de carga e configuração de rede, portanto, estão no caminho crítico para quase todos os produtos em nuvem.
Em nosso exemplo do Northstar, os clientes podem presumir que o próprio serviço de computação falhou porque as chamadas da API expiraram. Mas os servidores de computação reais podem estar funcionando corretamente, enquanto o DNS não retorna nenhum endpoint utilizável, uma rota está faltando ou um balanceador de carga removeu destinos válidos.
A AWS documentou esse modo de falha mais de uma vez. Em um incidente ocorrido na região de Seul em 2018, a AWS informou que uma atualização de configuração removeu incorretamente uma configuração que especificava o número mínimo de hosts íntegros para a frota de servidores DNS do EC2. A capacidade reduzida dos servidores DNS causou falhas nas consultas de DNS provenientes de instâncias do EC2. Os detalhes estão no resumo da AWS sobre o problema de resolução de DNS do EC2 em Seul em 2018 .
As falhas de rede também se amplificam rapidamente porque os aplicativos tentam novamente as conexões interrompidas. O comportamento agressivo de novas tentativas pode transformar uma deficiência parcial da rede em um aumento de tráfego muito maior.
4. Dependências compartilhadas fazem com que serviços não relacionados falhem em conjunto.
Os serviços em nuvem não são produtos isolados. Um banco de dados gerenciado pode depender de serviços de identidade, DNS interno, armazenamento, rede, sistemas de agendamento, serviços de certificado e telemetria. Uma plataforma sem servidor pode depender de capacidade computacional, rede, filas e bancos de dados de plano de controle. Se uma dependência compartilhada falhar, muitos produtos podem apresentar degradação simultaneamente.
Isso explica um dos sintomas de interrupção mais confusos: os clientes veem erros em vários serviços e presumem que ocorreram várias falhas independentes. Na realidade, as falhas visíveis podem ter a mesma causa a montante.
No cenário Northstar, o serviço de máquina virtual, o serviço de contêiner e o serviço sem servidor poderiam começar a falhar porque dependem do mesmo banco de dados de recursos interno. Os produtos voltados para o cliente são diferentes; a dependência subjacente a eles, não.
O incidente da AWS em outubro de 2025 demonstrou esse tipo de efeito cascata, quando serviços internos que dependiam do DynamoDB foram afetados pelo problema original de DNS, seguido por efeitos de recuperação subsequentes em EC2, Network Load Balancer, Lambda, serviços de contêiner, funções relacionadas à identidade e outros produtos.
5. A recuperação pode falhar porque o acúmulo de tarefas é maior que a carga operacional normal.
Restaurar o componente defeituoso original nem sempre resolve uma interrupção. Durante o período de inatividade, as filas aumentam, os contratos expiram, as verificações de integridade falham, os escaladores automáticos solicitam capacidade de substituição, os clientes repetem as solicitações e as atualizações de configuração se acumulam. Quando a dependência com falha retorna, todos os sistemas em espera podem tentar se recuperar simultaneamente.
No exemplo do Northstar, suponha que o DNS seja reparado às 10h45. Milhares de hosts de computação agora tentam renovar concessões expiradas. Ao mesmo tempo, os clientes tentam novamente implantações com falha e os sistemas de escalonamento automático solicitam instâncias de substituição. O plano de controle está repentinamente processando várias vezes sua carga de trabalho normal. Se não houver limites de taxa eficazes ou priorização de recuperação, ele pode entrar em um segundo modo de falha, mesmo que o bug original tenha sido corrigido.
A AWS descreveu um problema de recuperação semelhante em 2025: após o acesso ao DynamoDB ser restaurado, um subsistema EC2 teve que restabelecer um grande número de concessões. O acúmulo de solicitações tornou-se difícil de processar antes que os tempos limite fossem atingidos, e a AWS afirmou que o subsistema entrou em um estado de "colapso congestionado". Esse detalhe é importante porque mostra por que a duração da interrupção pode ser muito maior do que o tempo necessário para corrigir o problema inicial.
6. As verificações de integridade e o failover automático podem, por vezes, consumir recursos úteis.
As verificações de integridade são essenciais, mas também são tomadas de decisão automatizadas. Se uma rede estiver lenta ou a propagação de estado estiver atrasada, um sistema de verificação de integridade pode concluir que recursos saudáveis estão com problemas e removê-los de serviço. Isso pode reduzir ainda mais a capacidade, criando um ciclo vicioso.
No cenário fictício, os balanceadores de carga da Northstar começam a verificar instâncias recém-lançadas antes que a configuração da rede tenha se propagado completamente. As verificações falham, instâncias íntegras são removidas, o tráfego se desloca para o número reduzido de nós restantes e esses nós ficam sobrecarregados.
Esse padrão também apareceu durante o evento da AWS de 2025. A AWS afirmou que as verificações de integridade do Network Load Balancer às vezes falhavam enquanto o estado da rede para novas instâncias ainda estava se propagando, o que levava à remoção de capacidade do serviço. Isso serve como um lembrete de que a lógica de failover deve ter sua taxa de requisições limitada e ser testada em condições de falha parcial, e não apenas em condições ideais de "saudável/não saudável".
7. Permanecem possíveis falhas em data centers, sistemas de energia, refrigeração e zonas de disponibilidade.
Nem toda interrupção começa no software. Energia, refrigeração, fibra óptica, hardware de rede e outras infraestruturas físicas podem falhar. A arquitetura em nuvem é projetada levando em conta essa realidade, e é por isso que os principais provedores dividem as regiões em zonas isoladas contra falhas.
A Microsoft explica que as Zonas de Disponibilidade do Azure são grupos separados de datacenters com energia, refrigeração e rede independentes. A Microsoft também observa que uma implantação zonal não sobrevive automaticamente a uma interrupção de zona; os clientes devem usar várias zonas ou serviços redundantes em relação à zona, quando compatíveis. Consulte a visão geral oficial das Zonas de Disponibilidade do Azure da Microsoft .
Na prática, um provedor de nuvem pode tornar uma zona independente, mas a carga de trabalho de um cliente ainda pode ter um banco de dados de zona única, uma dependência de controle regional única ou um processo de failover que nunca foi acionado.
Por que uma interrupção na nuvem pode parecer global mesmo quando a causa raiz é regional?
A expressão "interrupção global" geralmente descreve o impacto nos clientes, e não a localização física do equipamento com falha. Um serviço regional pode dar suporte à autenticação, DNS, metadados, pipelines de compilação, painéis de controle ou APIs de controle usadas em outras regiões. Portanto, aplicativos em todo o mundo podem falhar por dependerem de um serviço concentrado em um único local.
Essa distinção é importante no diagnóstico de um incidente. Os engenheiros devem fazer duas perguntas diferentes: Onde ocorreu a primeira falha? E quais dependências permitiram que essa falha se propagasse? As respostas costumam ser diferentes.
Como identificar a causa provável durante um incidente em andamento
Para os operadores, o caminho mais rápido geralmente é correlacionar os sintomas em vez de investigar cada produto separadamente. Se muitos serviços falharem no mesmo minuto, procure por uma dependência compartilhada. Se as cargas de trabalho existentes permanecerem íntegras enquanto novas implantações falharem, suspeite de um problema no plano de controle, no agendamento, na capacidade ou no provisionamento. Se a conectividade IP funcionar, mas os nomes de serviço falharem, investigue o DNS. Se as taxas de erro aumentarem após um anúncio de recuperação, procure por tempestades de novas tentativas, atrasos, concessões expiradas, loops de feedback de verificação de integridade ou capacidade de recuperação insuficiente.
Os sistemas de status do provedor também podem ajudar a distinguir um incidente de plataforma de uma falha específica do aplicativo. O Google Cloud, por exemplo, publica incidentes atuais e históricos por meio de seu painel oficial de integridade do serviço , enquanto a AWS publica resumos de eventos importantes por meio de seus resumos pós-evento oficiais .
O que os clientes podem fazer para reduzir o impacto
Nenhuma arquitetura pode garantir zero tempo de inatividade, mas diversas escolhas de design reduzem a exposição a vulnerabilidades. Utilize múltiplas zonas de disponibilidade para cargas de trabalho de produção quando o serviço as suportar. Para cargas de trabalho que não toleram uma interrupção regional, avalie designs multirregionais e compreenda as compensações em termos de consistência de dados. Elimine pontos únicos de falha ocultos, como um único serviço de identidade regional, um único caminho de DNS ou uma única API administrativa da qual toda ação de recuperação depende.
Os aplicativos também devem falhar de forma controlada. Isso pode significar servir conteúdo em cache, enfileirar gravações não críticas, limitar novas tentativas com recuo exponencial e jitter, separar as operações do plano de controle do tráfego do plano de dados e preservar um modo reduzido de "somente leitura" ou "transação principal" durante interrupções parciais. Os procedimentos de recuperação devem ser testados em condições de backlog, pois reiniciar uma dependência em um ambiente de teste vazio é muito diferente de restaurá-la enquanto milhões de solicitações estão aguardando.
A principal lição aprendida com a indisponibilidade generalizada da nuvem.
Retomando o cenário da Northstar Cloud. A alteração de configuração das 10h05 pode ter sido o gatilho, mas não explica tudo. A interrupção se torna generalizada porque a rede é compartilhada, a automação apresenta uma falha de sincronização, os serviços subsequentes dependem do mesmo estado, as verificações de integridade consomem capacidade, as novas tentativas aumentam a carga e os sistemas de recuperação precisam processar um enorme acúmulo de processos.
Esse é o padrão central por trás de muitos incidentes graves na nuvem: a falha inicial costuma ser pequena em comparação com a cadeia de dependências que a amplifica. Compreender o tempo de inatividade na nuvem significa, portanto, examinar tanto a causa raiz quanto a propagação. Os projetos mais resilientes partem do princípio de que componentes individuais falharão e se concentram em evitar que essas falhas se tornem eventos que afetam todo o sistema.