Início
» Tecnologia
»
Semicondutores de Próxima Geração: Como a IA e a Supercomputação Estão Indo Além dos Transistores Menores
Semicondutores de Próxima Geração: Como a IA e a Supercomputação Estão Indo Além dos Transistores Menores
Em resumo: os ganhos em IA agora provêm de todo o sistema de semicondutores.
A próxima geração de hardware de IA e supercomputação não está sendo impulsionada por uma única inovação. Ela está sendo construída a partir de diversas tecnologias que precisam funcionar em conjunto: transistores gate-all-around, fornecimento de energia pela parte traseira, arquiteturas de chiplets, encapsulamento avançado, memória de alta largura de banda, links die-to-die mais rápidos e, cada vez mais, redes ópticas. O resultado prático é mais poder computacional, mais largura de banda de memória e melhor escalabilidade, sem depender apenas de dimensões menores de transistores.
Isso é importante porque os aceleradores de IA modernos e os supercomputadores científicos frequentemente atingem os limites de movimentação de dados e de energia antes de esgotarem sua capacidade aritmética bruta. Um mecanismo de matrizes mais rápido só é útil se os pesos do modelo, as ativações e os resultados intermediários puderem chegar até ele com rapidez suficiente. Da mesma forma, adicionar mais aceleradores só é útil se o pacote, a rede de racks, o sistema de memória, o sistema de refrigeração e a pilha de software conseguirem mantê-los ocupados.
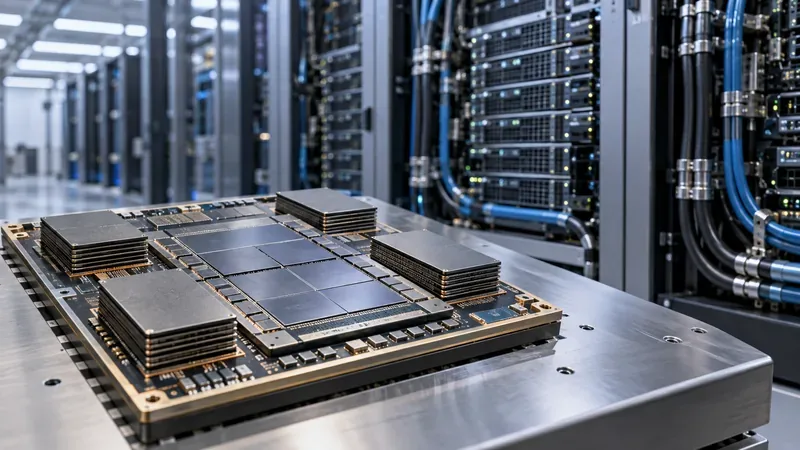
Um módulo acelerador multichip com vários pacotes de memória empilhados ilustra a direção do hardware de IA moderno: computação, memória, encapsulamento, fornecimento de energia e resfriamento são cada vez mais projetados como um único sistema.
1. Novas estruturas de transistores melhoram a eficiência, mas são apenas o ponto de partida.
A lógica de ponta está indo além da estrutura FinFET que dominou os chips avançados por anos. Os designs Gate-All-Around (GAA, na sigla em inglês) envolvem o gate em torno de uma nanochapa ou estrutura de canal similar, proporcionando aos projetistas de chips um controle eletrostático mais preciso à medida que os componentes diminuem de tamanho. Isso pode melhorar o desempenho, reduzir a fuga de corrente ou proporcionar um melhor equilíbrio entre os dois.
A TSMC afirma que seu processo N2 de 2 nanômetros entrou em produção em volume no quarto trimestre de 2025, enquanto sua tecnologia A16 combina transistores de nanofolhas com um circuito de alimentação na parte traseira, voltados especialmente para produtos de computação de alto desempenho com necessidades de fornecimento de energia de alta densidade. A TSMC informou que a produção em volume da tecnologia A16 está prevista para o segundo semestre de 2026. Consulte a página da tecnologia A16 da empresa e o relatório anual de 2025 .
A Intel está seguindo uma direção semelhante com o processo Intel 18A. Este processo combina transistores RibbonFET GAA com a tecnologia PowerVia para fornecimento de energia pela parte traseira. A Intel informa que o 18A entrou em produção em 2025, enquanto a versão aprimorada 18A-P entrou em produção em série em junho de 2026. A Intel também publica dados comparativos de desempenho, consumo de energia e densidade para o processo; esses números são fornecidos pelo fabricante e devem ser validados em relação a um projeto específico, em vez de serem considerados ganhos universais em nível de chip. Os detalhes atuais estão disponíveis na página do processo 18A da Intel .
A alimentação pela parte traseira é importante porque os chips avançados precisam rotear tanto sinais quanto energia através de uma fiação extremamente densa. Mover parte da rede de distribuição de energia para a parte traseira pode liberar recursos de roteamento no lado do sinal e melhorar a distribuição de tensão. Para aceleradores de IA, onde grandes conjuntos de unidades de computação operam em altas taxas de comutação, isso pode ser tão importante quanto a densidade de transistores.
2. Chiplets e embalagens avançadas estão transformando um pacote em um pequeno sistema de computação.
Os chips monolíticos tornam-se mais difíceis e caros de escalar à medida que crescem. Os chiplets oferecem um caminho alternativo: funções separadas podem ser fabricadas em tecnologias de processo que melhor se adequem a elas e, em seguida, conectadas dentro de um único encapsulamento. Um chip de computação pode exigir o processo lógico mais avançado, enquanto E/S, cache, circuitos analógicos ou outras funções podem não exigir.
A embalagem é o que torna isso viável. A plataforma de embalagem avançada CoWoS da TSMC , por exemplo, foi projetada para integrar múltiplos dispositivos lógicos e conjuntos de memória de alta largura de banda em um pacote 2.5D. A TSMC posiciona especificamente a CoWoS para produtos de IA e HPC, onde conexões curtas e amplas entre computação e HBM são essenciais.
Estão surgindo também padrões para tornar os chiplets menos proprietários. A especificação UCIe 3.0 , lançada em agosto de 2025, suporta taxas de dados de 48 GT/s e 64 GT/s e adiciona recursos para eficiência energética, gerenciamento e sistemas multichip mais flexíveis. A UCIe não torna os chiplets intercambiáveis da noite para o dia, mas oferece à indústria uma estrutura elétrica e de protocolo comum para links no encapsulamento.
Essa abordagem é especialmente atraente quando uma empresa deseja construir diversas variantes de aceleradores a partir de componentes reutilizáveis. Ela se torna menos atraente quando o custo da embalagem, a densidade térmica ou a complexidade do projeto superam o benefício da modularidade. Um produto menor, com necessidades modestas de memória e E/S, ainda pode ser melhor atendido por um dispositivo monolítico mais simples.
3. A memória de alta largura de banda está se tornando tão estratégica quanto o próprio acelerador.
As cargas de trabalho de IA movem repetidamente grandes tensores entre a memória e as unidades de computação. Isso faz com que a largura de banda da memória seja uma restrição de projeto fundamental. A memória de alta largura de banda, ou HBM, resolve esse problema empilhando chips DRAM e posicionando-os fisicamente próximos ao acelerador por meio de uma interface muito ampla.
A tecnologia HBM4 está agora passando da fase de planejamento para a comercialização em sistemas. A Samsung anunciou o início das remessas comerciais de HBM4 em fevereiro de 2026 e afirmou que seu produto entrou em produção em massa com uma taxa de transferência sustentada de 11,7 Gb/s, com capacidade para atingir até 13 Gb/s. Em maio de 2026, a Samsung também anunciou o envio de amostras de HBM4E. Esses detalhes estão disponíveis no anúncio de produção de HBM4 da Samsung .
A SK hynix informou em seus resultados do segundo trimestre de 2026 que iniciou os envios em massa de HBM4 durante o trimestre e planeja aumentar a produção no segundo semestre do ano. A empresa também já enviou amostras de HBM4E de 12 camadas. Consulte os resultados do segundo trimestre de 2026 da SK hynix para obter informações sobre o status atual.
Por que isso importa na prática? As especificações atuais da NVIDIA para a Vera Rubin listam 288 GB de HBM4 em uma GPU Rubin e 19,2 TB/s de largura de banda de memória da GPU. Em comparação, os aceleradores da série MI350 da AMD usam HBM3E; a AMD lista até 288 GB e 8 TB/s para o MI355X. Essas são arquiteturas diferentes e não devem ser comparadas apenas com base em um valor de largura de banda, mas ambas ilustram como a capacidade de memória e a largura de banda agora são especificações essenciais dos aceleradores, em vez de detalhes secundários. Consulte as especificações oficiais da NVIDIA Vera Rubin NVL72 e a página da série AMD Instinct MI350 .
4. As interconexões de escalabilidade vertical e horizontal determinam se vários aceleradores atuam como um só.
Modelos complexos e simulações científicas raramente cabem perfeitamente em um único dispositivo. O sistema precisa dividir o trabalho entre vários aceleradores e trocar resultados parciais com frequência. Se a comunicação for lenta, unidades de computação caras ficam ociosas.
É por isso que as arquiteturas proprietárias de escalonamento estão avançando juntamente com as próprias GPUs. A plataforma Rubin da NVIDIA utiliza NVLink de sexta geração; a NVIDIA anuncia 3 TB/s de largura de banda NVLink por GPU Rubin e 216 TB/s em um sistema NVL72. A AMD utiliza o Infinity Fabric em suas plataformas aceleradoras. Para os compradores, a questão importante não é apenas a largura de banda máxima do link, mas como a arquitetura se comporta sob as operações coletivas exatas, os padrões de paralelismo de modelo e a topologia utilizada pela aplicação.
No nível da memória do sistema, o Compute Express Link também está evoluindo. O Consórcio CXL afirma que o CXL 4.0 dobra a velocidade de sinalização de 64 GT/s para 128 GT/s, adiciona portas agrupadas e expande os recursos de confiabilidade da memória. O CXL é relevante quando os arquitetos desejam expansão, agrupamento ou desagregação de memória coerentes sem tratar cada camada de memória como um dispositivo de armazenamento remoto.
5. A fotônica de silício está se aproximando do silício de comutação.
O cobre continua sendo uma excelente opção para conexões elétricas curtas e densas, mas as conexões ópticas tornam-se cada vez mais atraentes à medida que a distância e a largura de banda agregada aumentam. Um importante passo adiante é a óptica co-embalada, na qual os componentes ópticos são movidos para mais perto do ASIC de rede, em vez de estarem inteiramente em transceptores plugáveis na borda de um switch.
A NVIDIA afirma que sua plataforma Spectrum-X Ethernet Photonics utiliza componentes ópticos integrados e apresenta uma eficiência energética de rede até 5 vezes superior aos designs tradicionais de transceptores plugáveis. Essa é uma comparação entre fornecedores, não uma garantia para todas as topologias de data center, mas destaca a tendência: o consumo de energia da rede está se tornando tão relevante que a integração óptica agora faz parte do design de sistemas semicondutores. Veja a visão geral da NVIDIA sobre fotônica de silício .
O que isso significa para cargas de trabalho reais de IA e supercomputação?
Carga de trabalho
Características dos semicondutores a serem priorizadas
Por que são importantes
Pré-treinamento de modelos grandes
Capacidade e largura de banda HBM, links de expansão rápida, encapsulamento denso, resfriamento robusto.
O treinamento dedica-se intensamente ao movimento de tensores e à comunicação sincronizada entre vários aceleradores.
Contexto longo e inferência agentiva
Grandes pools de HBM, computação eficiente de baixa precisão, alta largura de banda de interconexão, hierarquização de memória.
O cache KV e as etapas de raciocínio repetidas podem fazer com que a capacidade de memória e a movimentação de dados sejam mais limitantes do que o pico de FLOPS.
HPC científico
Capacidade FP64, largura de banda de memória, interconexões confiáveis, bibliotecas numéricas consolidadas.
Os códigos de simulação frequentemente dependem de dupla precisão e largura de banda sustentada, em vez de apenas baixa precisão na taxa de transferência de tensores.
Inferência empresarial
Desempenho por watt, compatibilidade de software, memória dimensionada corretamente, opções de implementação PCIe
O melhor sistema pode ser aquele que se adapta aos servidores e às capacidades de energia existentes, em vez da arquitetura de rack de maior densidade.
Aceleradores personalizados
Estratégia de chiplets, ecossistema de embalagens, suporte da UCIe, maturidade do processo
A modularidade pode encurtar os ciclos de reutilização, mas a complexidade da embalagem e a qualificação da cadeia de suprimentos podem anular esse benefício.
Um exemplo concreto: por que uma GPU mais rápida não é suficiente
Considere uma equipe que trabalha com um modelo de linguagem complexo e com longas janelas de contexto. Suponha que a análise de desempenho mostre que as GPUs frequentemente ficam aguardando transferências de memória e comunicação entre GPUs. A migração para um acelerador mais recente poderia ajudar, mas somente se o novo sistema também oferecer capacidade de HBM suficiente, largura de banda de memória mais rápida e uma topologia que reduza as interrupções de comunicação. Comprar um dispositivo com desempenho teórico superior em relação a tensores, mantendo os mesmos gargalos de memória e rede, pode resultar em uma melhoria muito menor do que a sugerida pelas especificações.
O mesmo princípio se aplica à supercomputação tradicional. O sistema Frontier do Laboratório Nacional de Oak Ridge combina aceleradores AMD MI250X com HBM e uma interconexão de sistema de alta velocidade. O guia do usuário do Frontier documenta como os recursos de computação, HBM, links CPU-GPU e a rede Slingshot funcionam em conjunto. A geração de hardware é anterior às plataformas de IA mais recentes de 2026, mas a lição arquitetônica permanece válida: o desempenho sustentado de uma aplicação depende do caminho entre os nós de computação, memória e outros nós.
Quando vale a pena investir em hardware semicondutor de última geração?
Uma atualização é mais justificável quando resolve um gargalo comprovado, em vez de simplesmente substituir uma peça com número de peça antigo. Antes de optar por uma nova geração de aceleradores, verifique o seguinte:
Pressão sobre a memória: o modelo ou a simulação ocupam toda a memória do host, exigem checkpoints agressivos ou forçam um grau inconveniente de particionamento do modelo?
Pressão sobre a largura de banda: os kernels estão limitados pela memória durante a criação de perfis, ou os aceleradores estão gastando um tempo significativo aguardando a conclusão de operações coletivas como all-reduce?
Energia e refrigeração: o rack, as instalações e o circuito de refrigeração suportam a nova densidade de energia? Um desempenho mais elevado ainda pode não ser viável se as atualizações de infraestrutura representarem a maior parte dos custos.
Prontidão do software: O compilador, as bibliotecas, os kernels, a pilha de orquestração e as ferramentas de monitoramento estão maduros para a nova arquitetura?
Requisitos de precisão: A carga de trabalho pode usar com segurança formatos de menor precisão ou requer FP64 ou outro formato de maior precisão?
Utilização: A carga de trabalho manterá o novo hardware ocupado o suficiente para justificar seu custo? Capacidade ociosa não se torna economicamente viável apenas porque o chip é mais novo.
As compensações estão se tornando mais físicas.
Os avanços na área de semicondutores estão gerando capacidades impressionantes, mas os fatores limitantes estão cada vez mais tangíveis. Os encapsulamentos avançados são maiores e mais difíceis de fabricar. As pilhas HBM concentram o calor próximo à lógica de alta potência. Sistemas em escala de rack podem exigir refrigeração líquida, distribuição de energia densa e redes especializadas. A óptica co-embalada pode reduzir o consumo de energia da rede, mas introduz novas considerações de fabricação e manutenção. Os chiplets podem melhorar a modularidade, mas aumentam o trabalho de validação, encapsulamento e gerenciamento de rendimento.
Existe também uma compensação em termos de software. Aritmética de baixa precisão, como FP8, FP6 ou FP4, pode aumentar consideravelmente a produtividade da IA, mas o software precisa preservar a qualidade do modelo. Códigos científicos podem não ser capazes de usar os mesmos atalhos. Um recurso de semicondutor só é valioso quando a pilha de aplicativos pode explorá-lo sem violar os requisitos de precisão ou confiabilidade.
O que assistir a seguir
Para o restante de 2026 e em 2027, os sinais mais úteis não são apenas os novos nomes de nós. Observe se os processos A16 da TSMC e da família 18A da Intel serão incorporados a uma ampla gama de produtos para clientes; a rapidez com que o HBM4 e o HBM4E estarão disponíveis em larga escala; se o UCIe 3.0 criará interoperabilidade significativa entre chiplets de diferentes fornecedores; onde o CXL 4.0 aparecerá em sistemas de produção; e se a óptica co-embalada se mostrará econômica e viável em larga escala de implantação.
Esses marcos mostrarão se a indústria de semicondutores pode continuar a expandir a IA e a supercomputação sem deixar que a movimentação de memória, o fornecimento de energia, as redes e o resfriamento consumam os ganhos obtidos com a lógica mais densa.
Resumindo
O futuro da IA e da supercomputação está sendo impulsionado menos por um único "próximo nó" e mais pela engenharia coordenada de semicondutores. Transistores GAA e alimentação pelo lado traseiro aprimoram a base lógica. Chiplets e encapsulamento avançado permitem que os projetistas montem sistemas maiores do que um único chip pode fornecer confortavelmente. A tecnologia HBM4 alimenta aceleradores com largura de banda extrema. UCIe, CXL, NVLink, Infinity Fabric e redes ópticas movem dados por domínios progressivamente maiores.
Ao escolher o hardware, comece identificando o gargalo real da sua carga de trabalho. Para IA com uso intensivo de memória, priorize a capacidade e a largura de banda da HBM. Para treinamento distribuído, priorize a escalabilidade vertical e horizontal da infraestrutura. Para computação científica, verifique o desempenho da arquitetura FP64 e das bibliotecas. Para implantações corporativas, considere o consumo de energia, o resfriamento, o suporte de software e o esforço de integração na sua decisão. O semicondutor mais rápido no papel não é automaticamente o sistema mais rápido ou mais econômico para a sua carga de trabalho.