Reduza a pressão de memória do PostgreSQL no Matrix Synapse
Descubra se a memória usada pelo PostgreSQL provém de consultas, buffers compartilhados, conexões ou manutenção e, em seguida, faça alterações direcionadas e seguras para o Synapse.
Comece verificando se as ingressões lentas afetam uma sala, um servidor remoto ou todas as salas federadas. Use o status e os registros de destino da federação do Synapse para localizar falhas repetidas antes de alterar os tempos limite ou adicionar servidores. Uma ingressão atravessa limites de servidores e troca dados de autorização de ingressão e de estado da sala; portanto, um servidor remoto lento ou uma sala grande podem atrasar uma ingressão, mesmo quando seu próprio servidor estiver funcionando corretamente.
A especificação servidor-servidor do Matrix descreve o make_joinhandshake send_joine o estado retornado a um servidor que está se juntando à federação. Isso significa que o "atraso na federação" não é automaticamente um problema local da fila do Synapse. As verificações abaixo distinguem as causas prováveis.
Compare uma entrada lenta com a entrada em uma sala federada diferente. Verifique se outros usuários em seu servidor doméstico relatam o mesmo atraso e anote o ID ou alias da sala e os nomes dos servidores remotos envolvidos. Se apenas uma sala estiver lenta, o estado da sala ou os servidores domésticos já presentes nela podem ser o gargalo. Se várias salas envolvendo o mesmo servidor remoto estiverem lentas, verifique a acessibilidade e o estado de novas tentativas desse destino. Se as entradas em muitos servidores não relacionados estiverem lentas, investigue seus próprios recursos e o caminho de federação de saída.
Para o servidor remoto afetado, consulte a API de Administração de Federação do Synapse a partir da máquina que executa o Synapse:
curl -H "Authorization: Bearer $SYNAPSE_ADMIN_TOKEN" \
  "http://127.0.0.1:8008/_synapse/admin/v1/federation/destinations/remote.example"
Substitua remote.examplepelo nome do servidor principal e use o endereço do cliente-ouvinte para sua implantação. Um valor diferente de zero retry_last_tse positivo retry_intervalindica que o Synapse registrou uma falha de conexão recente e está aguardando antes de tentar novamente. Verifique os logs correspondentes do Synapse para obter informações sobre a falha real, como erros de DNS, TLS, conexão ou resposta remota. O Synapse documenta esta API de Administração de Federação como experimental e sujeita a alterações; consulte a documentação da versão que você está executando. Mantenha a API de Administração privada e não cole seu token de acesso em uma solicitação de suporte pública.
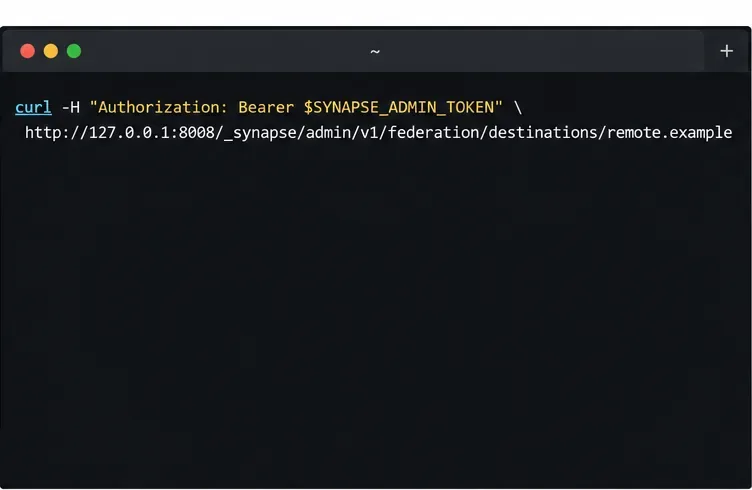
Ilustração de uma solicitação local e autenticada de status de destino. O painel mostra apenas um comando, não uma resposta em tempo real.
Se você suspeitar que outros servidores não conseguem alcançar seu servidor doméstico, execute o Matrix Federation Tester oficial para o nome do seu servidor. Ele verifica a descoberta de federação pública e a conectividade. Ele não comprova, por si só, que uma solicitação de saída do seu host Synapse para um determinado servidor foi bem-sucedida; portanto, compare o relatório com seus próprios registros e o status do destino.
Se o Prometheus já estiver coletando métricas do seu endpoint do Synapse, adicione os domínios afetados em ` federation_metrics_domains<nome_do_arquivo> homeserver.yaml`, e então recarregue ou reinicie o Synapse de acordo com o seu processo de implantação. O Synapse pode expor as métricas do Prometheus referentes à idade dos eventos persistentes de sala (PDUs) enviados e recebidos dos domínios listados, conforme descrito no manual de configuração :
federation_metrics_domains:
  - matrix.org
  - remote.example
Use a série temporal resultante para verificar se a idade dos eventos de saída ou de entrada está aumentando. Considere-a como uma indicação, não como um veredito: a documentação de configuração do Synapse alerta que o atraso pode vir tanto do servidor de origem quanto da rede entre eles. Uma série temporal de saída com atraso em vários destinos aponta para o seu caminho de envio ou para a capacidade local; um atraso isolado a um único nó exige a verificação desse nó e da rota até ele.
Ilustração de um gráfico conceitual da era da federação; as linhas não representam medições em tempo real de um servidor Synapse.

Ilustração da configuração do Synapse usada para ativar as métricas de idade de PDU para domínios remotos selecionados.
Se muitas operações estiverem lentas, verifique também o uso da CPU, da memória, a latência do banco de dados e o painel de duração de transações do Synapse. O guia do Grafana do Synapse observa que persist_eventsas gravações de eventos no banco de dados podem ter uma alta duração de transação; também explica que muitas operações de encaminhamento podem aumentar o trabalho de resolução de estado. Se essas métricas locais estiverem elevadas ao mesmo tempo que as junções, resolva o gargalo de recursos ou do banco de dados antes de ajustar as tentativas de federação.
Adicione capacidade de envio somente quando o monitoramento mostrar que o trabalho de saída está acumulado em vários destinos e o processo atual está sobrecarregado. A documentação atual do worker do Synapse recomenda o uso synapse.app.generic_workerdo `with` federation_sender_instancespara essa função, em vez de criar novas implantações em torno do tipo de worker de envio dedicado mais antigo.
Cada destino de saída é atribuído a um remetente com base em um hash do nome do servidor remoto. Vários servidores de envio podem distribuir o tráfego entre vários servidores remotos, mas as solicitações para um destino lento ainda são mapeadas para um único servidor. Portanto, adicionar servidores provavelmente não resolverá um problema de conexão com um único par. Os nomes dos servidores na configuração compartilhada devem corresponder aos servidores em execução; ao alterar a lista de instâncias de remetente, pare e inicie todos os remetentes da federação simultaneamente para que usem a mesma configuração.
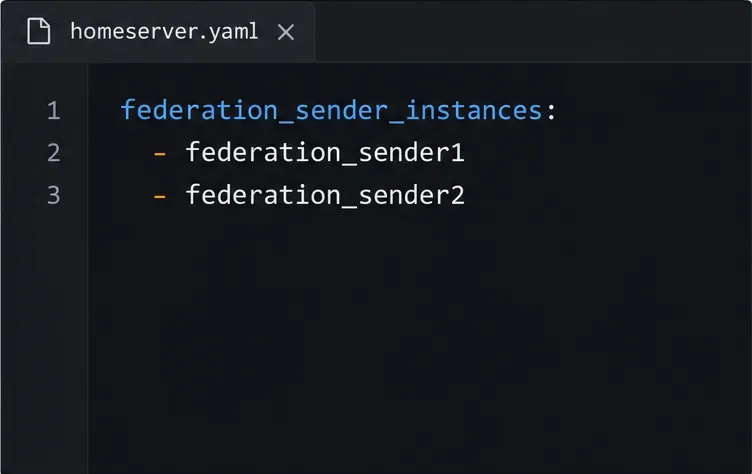
Ilustração da lista federation_sender_instances; cada worker nomeado deve existir na implantação.
Redefina o temporizador de novas tentativas de um destino somente após corrigir um problema transitório de conectividade e confirmar que o Synapse marcou esse destino como falho. A API de administração fornece um POST /_synapse/admin/v1/federation/destinations/<destination>/reset_connectionendpoint; sua solicitação é executada em segundo plano, portanto, um HTTP 200 imediato não significa que a federação foi recuperada. Este endpoint também está documentado como experimental.
Não utilize essa opção federation.client_timeoutcomo primeira resposta. O manual de configuração atual define um tempo limite padrão de 60 segundos. Um tempo limite maior dá mais tempo para um servidor remoto lento responder; isso não torna o servidor ou a rede mais rápidos e pode fazer com que as solicitações de ingresso fiquem em espera por mais tempo. Altere esse valor somente quando os registros mostrarem que as solicitações legítimas de federação estão excedendo o valor atual e você tiver verificado a capacidade do servidor.
Tente novamente ingressar na mesma sala e compare com uma sala federada diferente. Confirme se o destino afetado não apresenta mais um intervalo de novas tentativas crescente, se os logs mostram solicitações de federação bem-sucedidas e se as métricas de idade de PDU configuradas param de aumentar. Se apenas uma sala permanecer lenta enquanto outros destinos estiverem funcionando corretamente, compartilhe o ID da sala, o servidor remoto envolvido, o período e as linhas de erro (com informações ocultadas) com os administradores da sala ou com o suporte da Synapse. Evite enviar tokens de acesso ou cabeçalhos de autorização completos.
Descubra se a memória usada pelo PostgreSQL provém de consultas, buffers compartilhados, conexões ou manutenção e, em seguida, faça alterações direcionadas e seguras para o Synapse.
Antes de alterar as configurações do Synapse, verifique se a lentidão na entrada de salas Matrix em um servidor remoto, o recuo da federação, a carga do banco de dados local ou a fila de remetentes de saída estão sendo afetados.
Impeça a criação de contas abertas em um servidor Synapse auto-hospedado ou mantenha os cadastros apenas por convite com tokens de registro de uso limitado.
Elimine o aviso de sessão não verificada do Element usando um dispositivo confiável ou uma chave de recuperação, com verificações que protegem seu histórico de bate-papo criptografado.
Diferencie a disputa de bloqueio de banco de dados dos bloqueios WebDAV expirados e, em seguida, escolha e configure a correção adequada para o ownCloud 10.
Rastreie uma tela em branco do ownCloud Web até a causa, como cache do navegador, recursos da web ausentes, erros de serviço ou configurações de URL de proxy reverso, com verificações direcionadas.
Defina o limite de memória PHP da web do ownCloud, reinicie o serviço correspondente e verifique o valor ativo sem confundi-lo com as configurações da CLI ou os limites de upload.
Descubra se o MySQL, o PHP, as configurações de socket ou as permissões do banco de dados estão bloqueando o ownCloud 10 e, em seguida, verifique se há uma solução segura.
Torne obrigatória a expiração de links públicos no ownCloud Classic, defina um tempo de vida máximo e verifique os compartilhamentos existentes que podem precisar de limpeza separada.
Habilite o TOTP por meio do Keycloak, inscreva usuários com segurança e entenda quando as configurações de MFA em nível de rota do Infinite Scale se aplicam.


