Início
» Como fazer
»
Primeiro, crie um cluster SLES 15 HA compatível com Fencing.
Primeiro, crie um cluster SLES 15 HA compatível com Fencing.
Para o SLES 15, registre a extensão SUSE Linux Enterprise High Availability e, em seguida, use- crm cluster inita crm cluster joinpara inicializar os nós. Antes de colocar os serviços no cluster, verifique a redundância de rede, o isolamento de nós (STONITH) e o quorum.
Este procedimento segue a documentação do SLE HA 15 SP7 atualizada em outubro de 2026. Confirme o pacote de serviços instalado e a arquitetura da CPU; os identificadores de registro e os detalhes de suporte podem variar.
1. Prepare os nós e a rede.
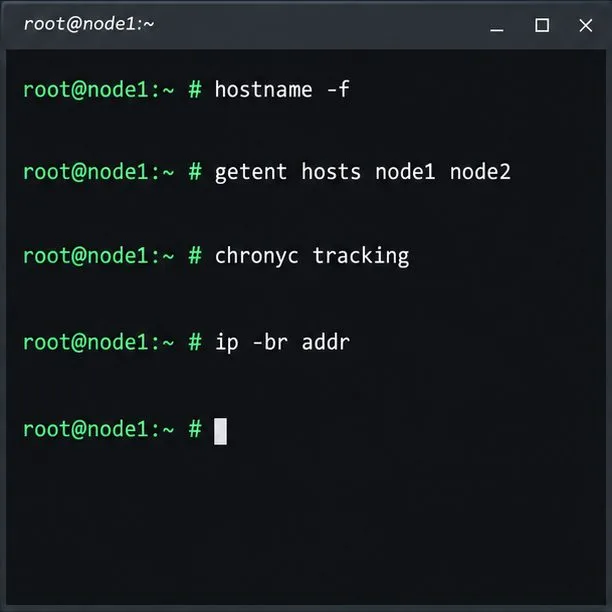
Antes de formar o cluster, verifique a nomenclatura do host, a resolução de nomes, a sincronização de tempo e o estado da interface em cada nó.
Utilize pelo menos dois nós com a mesma arquitetura de processador compatível, endereços IP primários estáticos, nomes exclusivos que possam ser resolvidos em cada nó e relógios sincronizados usando uma fonte de tempo externa. O SUSE exige dois caminhos de comunicação TCP/IP redundantes por nó; os nomes das interfaces devem ser iguais em todos os nós.
Execute as verificações em ambos os nós e confirme se as interfaces e os nomes selecionados estão corretos antes de iniciar o sistema.
2. Registre e instale a extensão de Alta Disponibilidade.
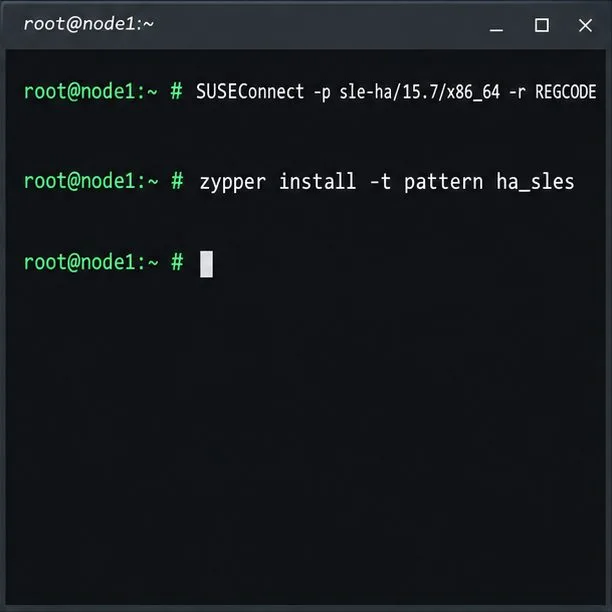
Em cada nó, registre a extensão SLE HA e instale seu padrão de gerenciamento de cluster.
O SLE HA é uma extensão registrada separadamente; o SLES sozinho não inclui o padrão de cluster. Para nós SLES 15 SP7 x86_64 registrados, habilite a extensão e instale o padrão em cada nó:
Substitua ADDITIONAL_REGCODEpelo seu código de assinatura. O identificador do produto é para x86_64; use o identificador correspondente da SUSE para outras arquiteturas. Mantenha todos os nós no mesmo SP do SLES e no mesmo nível de HA do SLE. Consulte o guia de instalação do SLES HA 15 SP7 da SUSE .
3. Defina o cercamento e o quórum antes de inicializar.
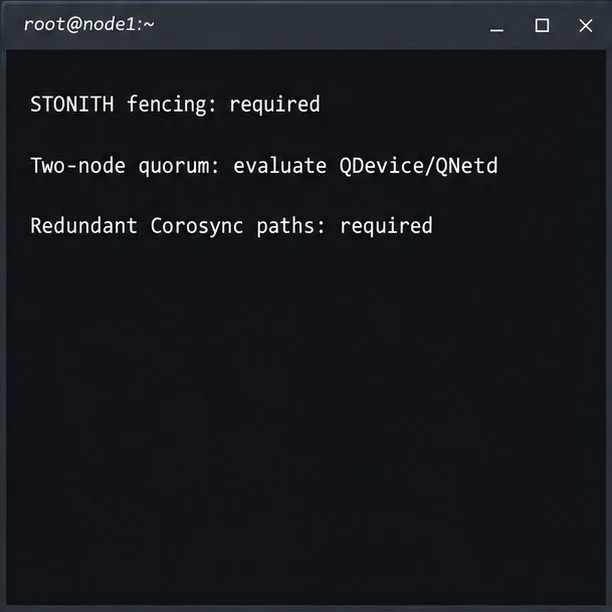
O isolamento de redes é um requisito de suporte; um cluster de dois nós também deve ser projetado levando em consideração o comportamento de quorum.
Requisito para clusters suportados: fencing de nós (STONITH), com `node stonith-enabledfencing` startup-fencingdefinido como verdadeiro. O fencing isola um nó incerto para impedir que ambos os lados de uma partição executem o mesmo serviço. Escolha um dispositivo de controle de energia ou SBD compatível com um watchdog testado para seu hardware ou hipervisor.
Para dois nós: a SUSE recomenda o uso de QDevice/QNetd em clusters com número par de nós. Ele adiciona uma votação de quorum independente, não um sistema de isolamento; configure primeiro o servidor QNetd separado se o QDevice for incluído durante a inicialização. Consulte o guia do QDevice e do QNetd .
Conceito errôneo sobre armazenamento: o armazenamento compartilhado não é obrigatório em todos os clusters, mas os dados da aplicação precisam de um design próprio, compartilhado, replicado ou recuperável. O Pacemaker move recursos; ele não copia dados da aplicação.
4. Inicialize o primeiro nó.
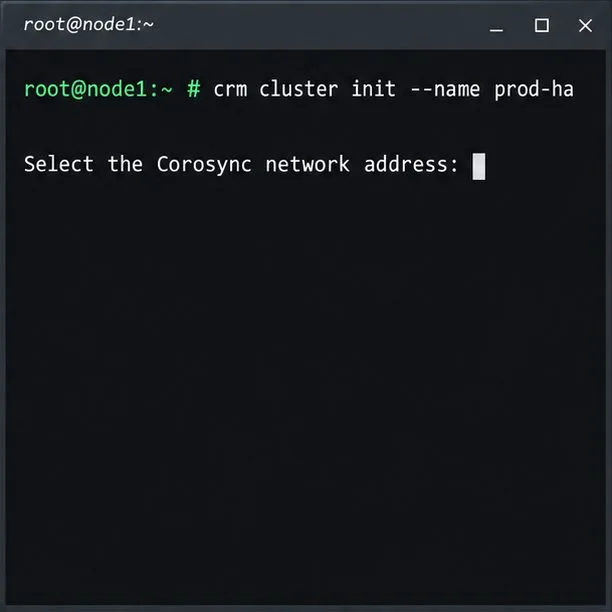
O script de inicialização começa no nó 1 e solicita o endereço de rede que o Corosync deve usar.
No nó 1, inicie o bootstrap do CRM Shell como root ou através da sua configuração de usuário sudo aprovada:
crm cluster init --name prod-ha
Siga as instruções e selecione o endereço Corosync desejado. O script configura o Corosync, SSH, Csync2, as portas do firewall do cluster e o Hawk2; ele verifica a sincronização de tempo e oferece, opcionalmente, SBD e um endereço IP de administração do Hawk2. Revise /var/log/crmsh/crmsh.logas configurações de inicialização.
Configure o watchdog em cada nó antes de selecionar o SBD. Se estiver usando fencing externo, configure o recurso STONITH compatível antes das cargas de trabalho. Nunca desabilite o STONITH para contornar um dispositivo ausente. O Bootstrap cria um cluster básico, não uma aplicação de alta disponibilidade.
5. Junte-se ao segundo nó.
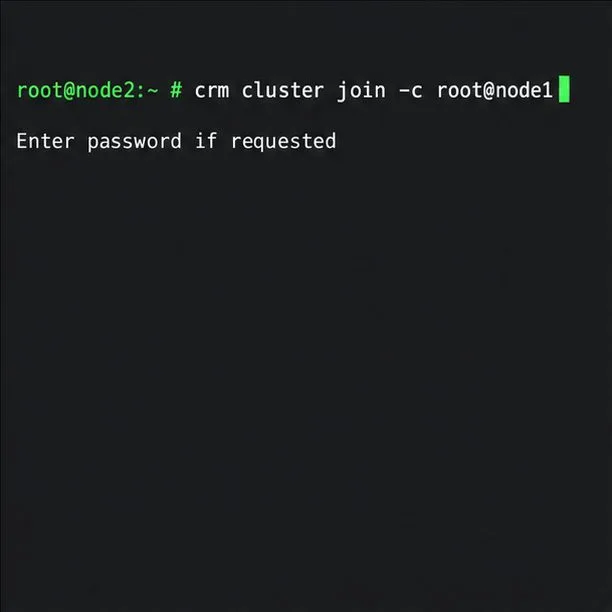
Execute o comando join no nó 2; use as mesmas opções de interface de rede feitas durante a inicialização.
Instale e registre o SLE HA no nó 2. Se estiver usando o SBD, prepare o watchdog dele antes de ingressar nele. Em seguida, como root:
crm cluster join -c root@node1
Para uma configuração com privilégios de sudo, utilize USER@NODE1o procedimento do SUSE. Especifique as mesmas duas interfaces, caso estejam configuradas na inicialização. O script copia as configurações do Corosync, configura o SSH e o Csync2 e coloca o nó 2 online. Repita o processo para os demais nós; não misture os métodos de inicialização (bootstrap) e de configuração do YaST.
6. Confirme a adesão e garanta a administração.
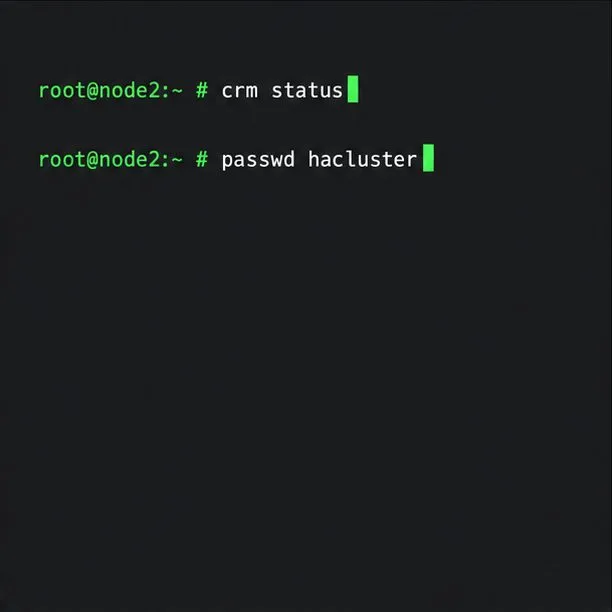
Verifique a associação com o status do CRM e substitua a senha do cluster HA de inicialização antes de usar o Hawk2.
A partir de um nó do cluster, verifique a associação:
crm status
Verifique se ambos os nós estão online e se há quórum. O bootstrap é criado haclustercom a senha inicial linux; altere-a em cada nó inicializado.
passwd hacluster
O Hawk2 utiliza HTTPS na porta 76308080. Verifique o certificado autoassinado com o seu administrador antes de confiar nele. O endereço IP de gerenciamento do Hawk2 não é o endereço IP do cliente do aplicativo.
7. Adicione recursos para o serviço que você realmente precisa proteger.
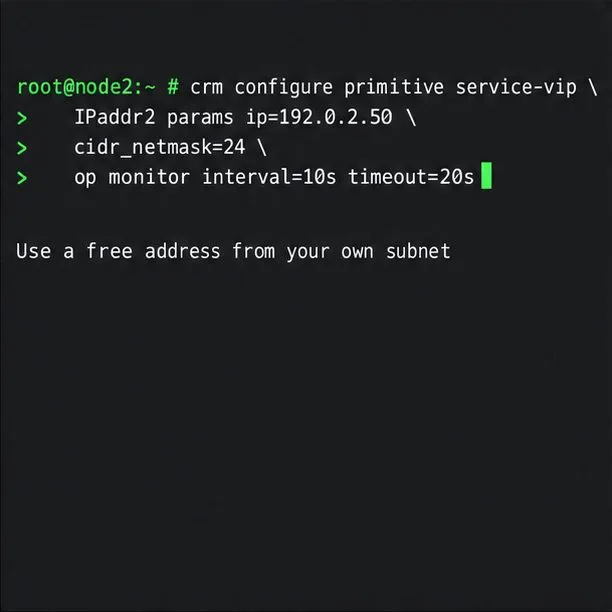
O exemplo define apenas um recurso IP flutuante; substitua o endereço de documentação por um endereço não utilizado da sua sub-rede.
O Pacemaker gerencia serviços por meio de agentes de recursos. Instale e configure a carga de trabalho adequadamente nos nós elegíveis. Este exemplo cria apenas um primitivo IP flutuante:
192.0.2.50é reservado para documentação. Substitua por um endereço livre e o prefixo correto da sua sub-rede. Um endereço IP primitivo não inicia um aplicativo nem replica dados. Adicione o agente compatível com o aplicativo, além do comportamento específico de ordenação, colocalização e armazenamento da carga de trabalho; siga as orientações de recuperação e isolamento do produto.
8. Teste o failover antes de declarar o cluster como pronto.
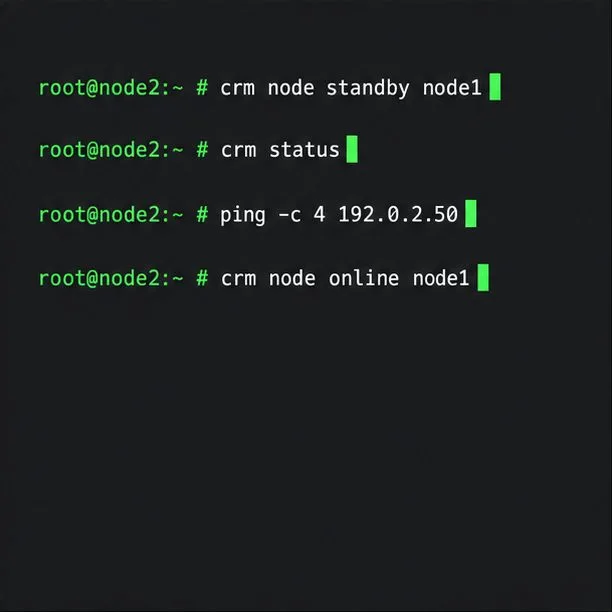
Um teste de espera planejado verifica se o recurso se move e, em seguida, coloca o nó de volta em serviço.
Após configurar os recursos reais e o fencing, agende um teste de failover controlado. Coloque o nó 1 em modo de espera e verifique o serviço a partir do nó 2:
Substitua SERVICE_VIPpelo endereço real do cliente. Confirme se o aplicativo responde, se os recursos são movidos conforme o esperado e se o nó 1 se reconecta. O comando ping verifica apenas a acessibilidade da rede. A SUSE crm cluster crash_testinterrompe componentes intencionalmente, portanto, use-o em um ambiente de teste planejado. Leia o guia de início rápido e o guia de isolamento da instalação de alta disponibilidade do SLE .
Verificar disponibilidade do serviço
Após os testes, confirme se ambos os nós apresentam o status esperado, se o fencing permanece habilitado e se a carga de trabalho responde por meio de seu endpoint de cliente após o nó 1 retornar à internet. Uma visualização de associação verde ou um ping bem-sucedido, por si só, não comprovam a recuperação do aplicativo.